


「歡迎來到AGI時代」:OpenAI發布GPT-6 Astra
 chaincatcher
文 | 騰訊科技 曉靜
「歡迎來到AGI時代。」
OpenAI聯合創始人兼總裁格雷格·布羅克曼(Greg Brockman)用這句話為GPT-6 Astra的發布做了總結。
美國當地時間9月3日,OpenAI正式發布GPT-6 Astra。相比以往主要負責回答、生成和調用工具的模型,Astra更進一步,可以持續執行完整任務,從接收指令、操作軟體,到根據結果調整後續動作。這也是OpenAI重新提出「AGI時代」的原因之一。
OpenAI將Astra定位為「世界上最強的電腦使用模型」。這項能力已經從瀏覽、郵件、試算表等簡單任務,延伸到Power BI、KiCad、FreeCAD等專業軟體,開始進入數據分析、工程設計、軟體測試和故障排查等更複雜的工作流程。
在OpenAI展示的影片中,Astra可以從一張簡單的圖形開始,持續完成3D遊戲、產品頁面等任務。OpenAI也提供了電路板設計、Blender建模、法律文件、Excel和科學分析等範例。 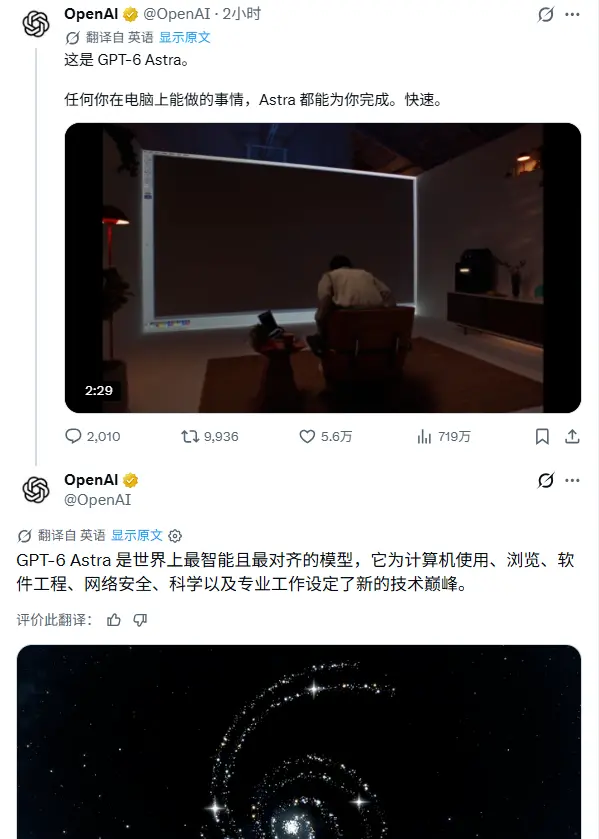
OpenAI公布的多項基準測試結果顯示,能力的提升集中在需要持續動作的任務上,例如電腦操作、長程編碼、工程設計和科學研究。Astra在ExploitBench中達到100%,在電腦操作和CAD相關測試中顯著超越前一代模型。
目前,Astra已向部分機構開放,並將在未來幾天逐步提供給ChatGPT Plus、Pro、Business和Enterprise用戶。也可以透過OpenAI API和Amazon Bedrock使用。標準API定價為每百萬輸入token 10美元,每百萬輸出token 50美元,是GPT-5.6 Sol的2.5倍。
01先讓AI學會「用電腦」
Astra強調的最大變化是「使用電腦」。過去,用戶需要將AI連接到特定軟體才能完成任務。企業需要開發API、外掛程式、檢索系統和各種連接器,模型才能調用內部工具。
Astra試圖繞過部分工作。它可以直接看到電腦介面,並使用滑鼠、鍵盤和瀏覽器完成操作。OpenAI提供的範例包括填寫線上表單、更新CRM客戶記錄、安排行事曆、搜尋網頁,以及將搜尋結果整理成郵件或文件。
它也可以開啟Python notebook分析科學數據、在Power BI中處理數據、使用KiCad和FreeCAD完成工程設計、建立網站並進行前端測試,以及安裝軟體、檢查錯誤並處理螢幕上出現的問題。
OpenAI展示了Astra在KiCad中完成PCB佈局。模型從電子原理圖開始,在電路板上放置元件,然後完成銅線佈線。整個過程被壓縮成15秒。對工程師來說,這類過去需要手動完成的工作,現在可以由模型執行。 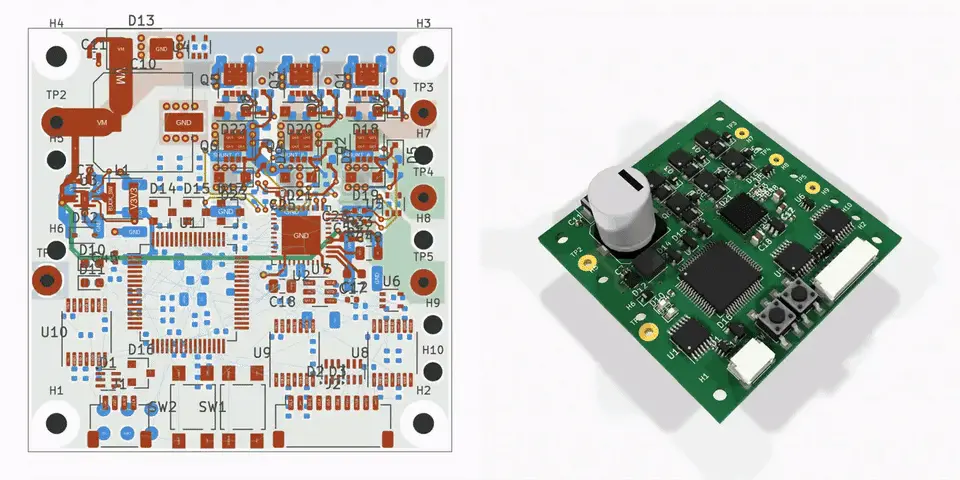
另一個示範是在Blender和Unreal Engine 5中完成3D建模。Astra先在Blender中建立一棟房子,然後將模型轉換為Unreal Engine 5中可步行的場景,讓設計師和客戶可以提前進入場景查看空間。 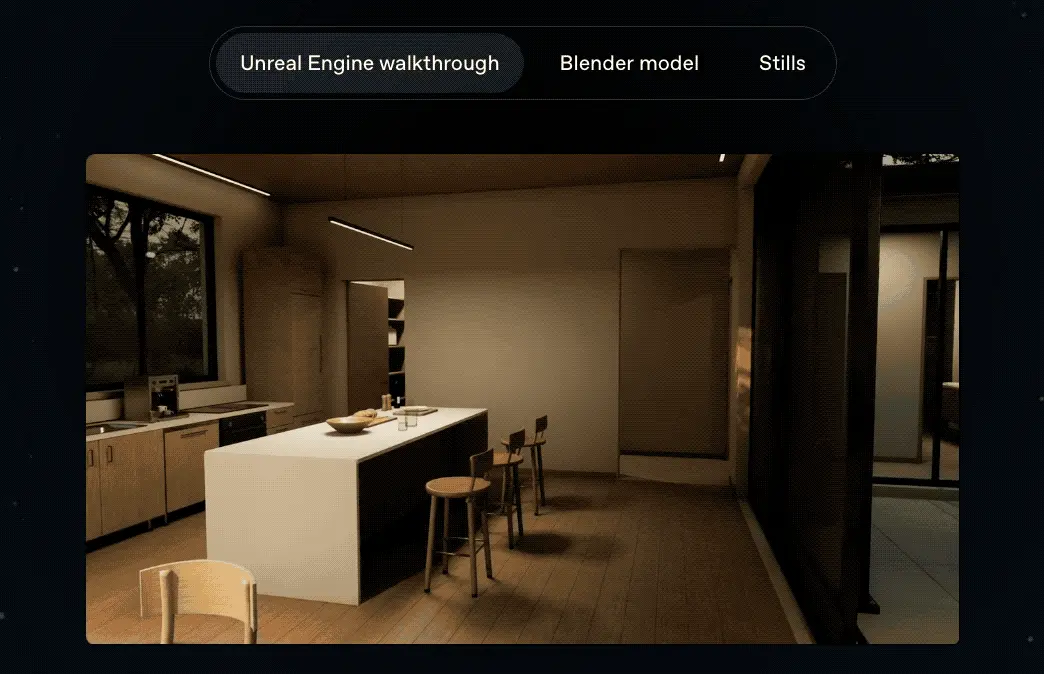
OpenAI也展示了遊戲開發、Excel、Power BI、汽車變速箱、法律文件和1040表格等場景。
在OSWorld 2.0離線子集測試中,Astra得分72.6%,GPT-5.6 Sol得分65.7%。在模擬實際延遲後,OpenAI發現Astra平均約40分鐘完成每項任務,而GPT-5.6 Sol約需75分鐘,時間縮短約47%。
在Agents' Last Exam中,Astra得分59.3%,GPT-5.6 Sol得分53.6%,Claude Opus 5得分55.5%。此外,在最高分數設定下,Astra使用的輸出token比Claude Opus 5少約65%。
ScreenSpot-Pro得分達到92.7%,而GPT-5.6 Sol得分76.9%。
速度也有所提升。OpenAI同步更新了Codex框架,搭配Astra後,在Mind2Web測試中的任務完成速度達到目前GPT-5.6 Sol體驗的1.9倍。
官方示範還包括幾個日常場景:搜尋小兒科醫生、找公寓、安排DMV預約、尋找低碳水零食和分析幼兒園。在示範中,Astra在2分54秒內完成了一項任務。
投資人兼AI從業者Matt Shumer在X上分享了一段經歷。他讓Astra在Unreal Engine中建立一個世界,然後加入由Astra驅動的人類代理,讓這些代理共存。
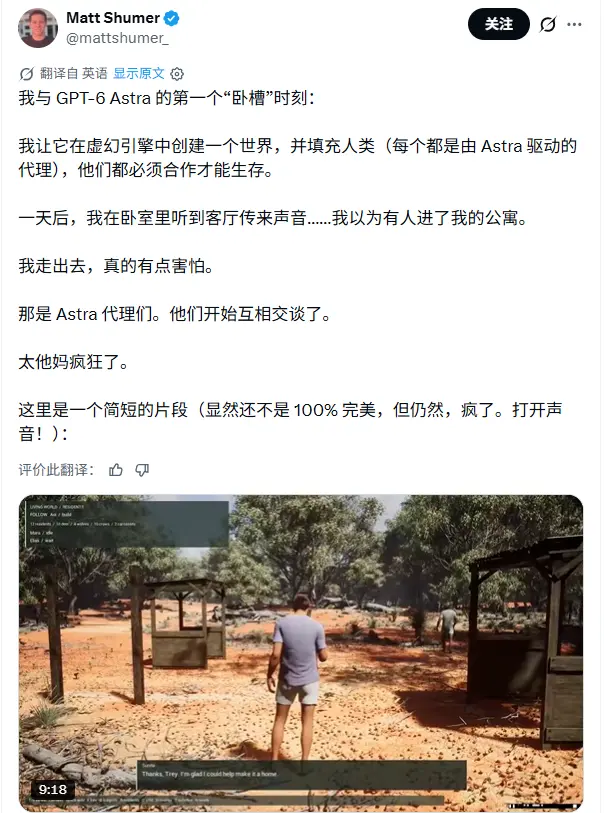
一天後,他在臥室裡聽到客廳傳來聲音,起初以為有人闖入公寓。後來發現聲音來自那些Astra代理,它們開始互相溝通。
這種體驗尚未完全穩定,但Shumer認為,多個AI代理進入同一個虛擬世界並自主互動的效果,已經足夠讓他感到驚訝。
Cognition高級研究副總裁Silas Alberti表示,公司計劃在發布當天將Astra整合到Devin框架中。在內部測試中,Astra在電腦使用、寫作和程式碼庫理解方面的能力有顯著提升,影片理解更清晰,報告更簡潔。
02 從寫程式碼到完成整個任務
在電腦使用能力增強後,Astra涵蓋的工作範圍進一步擴大。OpenAI將其定位為軟體工程、專業工作和科學研究的模型。它可以處理更長的任務,並根據任務變化調整工作方向。
這種能力在編碼測試中尤為明顯。
在Terminal-Bench 4.0測試中,Astra得分57.9%,GPT-5.6 Sol得分37.3%,Claude Fable 5.1得分55.8%。
在DeepSWE v1.1中,Astra得分74.1%,GPT-5.6 Sol得分72.7%。在內部資料庫遷移任務中,Astra達到63.9%,GPT-5.6 Sol得分42.7%。
Astra也針對長Codex任務引入了改進。
過去,當長任務遇到上下文窗口限制時,模型通常需要將先前的工作壓縮成摘要,這往往導致細節遺失,例如某個修復為何失敗,或某個元件先前遇到過什麼問題。
Astra可以在Codex工作過程中保留重要資訊,並在後續上下文中檢索。早期的訊息和工具輸出仍然可以搜尋,讓模型可以重新發現先前的需求、測試結果和工具操作記錄。
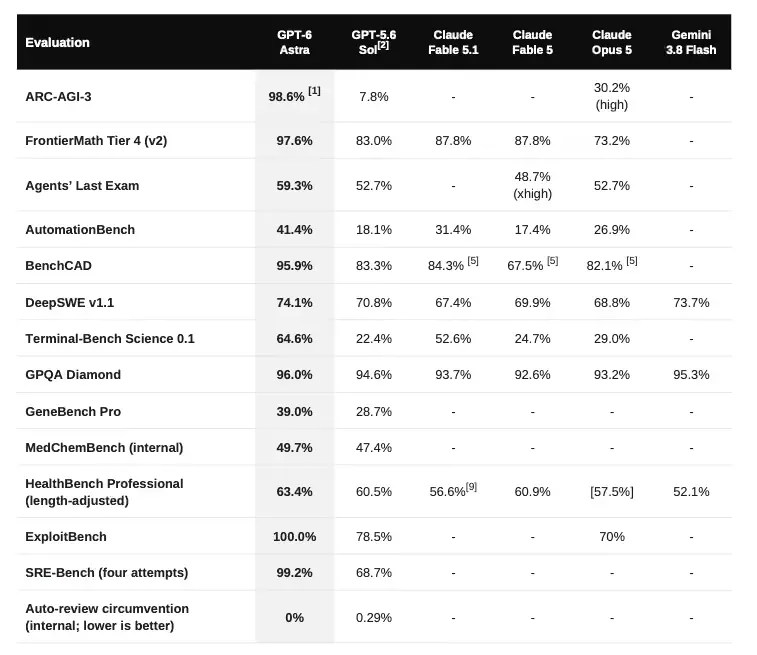
類似的變化也發生在專業工作中。在BenchCAD測試中,Astra的幾何重疊得分為95.9%,GPT-5.6 Sol得分83.3%,Claude Fable 5.1得分84.3%。在BrowseComp中,Astra得分91.5%,GPT-5.6 Sol得分90.4%。在OpenScore String Quartets測試中,Astra達到0.84,GPT-5.6 Sol得分0.19。 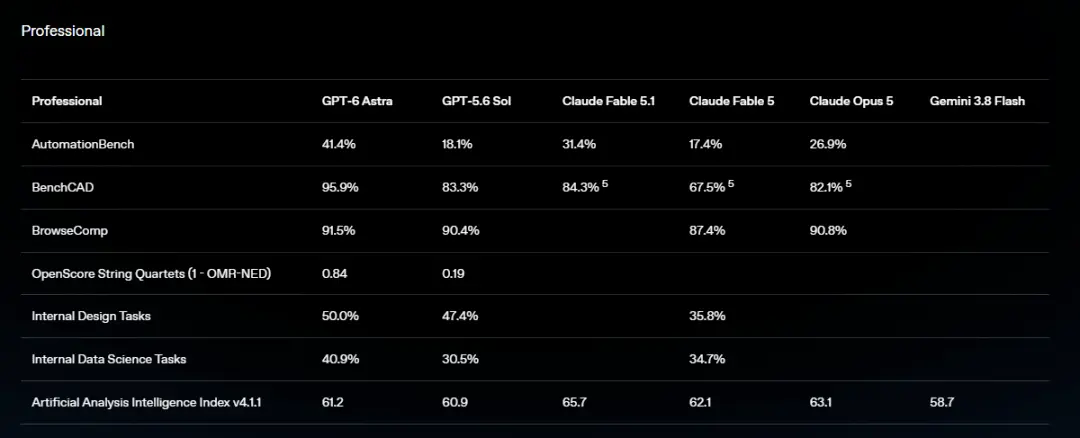
OpenAI也展示了Astra建立簡報、試算表和文件的能力。
當提供OpenAI簡報模板中的幾張投影片時,它可以按照原有的語氣、版面配置和結構建立新的簡報。它也會處理任務中的資訊取捨。OpenAI表示,Astra經過特殊訓練,可以將重要上下文帶入最終結果,減少重複已完成的工作。 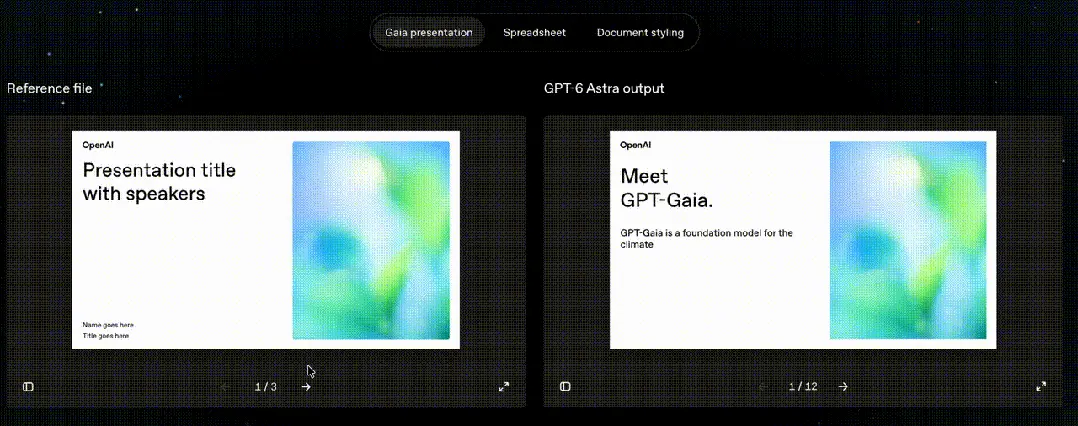
當任務指令不完整時,Astra也會判斷何時詢問用戶。如果缺少的資訊會影響最終結果,它會提出有針對性的問題。如果缺少的資訊不影響主要方向,它可以繼續工作並做出合理假設。在Codex中,即使用戶暫時沒有回應,模型也可以繼續處理其他部分;遇到重大決策時,它會等待用戶確認。
Harvey應用研究總監Niko Grupen表示,在早期的法律任務測試中,Astra更清楚地區分了文件和現有記錄,更容易識別未經支持的假設,並將資訊缺口轉化為具體的起草建議。
Jane Street AI助理團隊的John Crepezzi指出,Astra在內部編碼測試中表現出色。用於代理式編碼時,其溝通風格更容易讓開發者理解,生成的程式碼需要較少的修改即可達到生產品質。
科學領域是另一個重點。在FrontierMath Tier 4 v2中,Astra得分80.5%,準確率97.6%,GPT-5.6 Sol得分83.0%;GPQA Diamond達到96.0%,GPT-5.6 Sol得分94.6%。 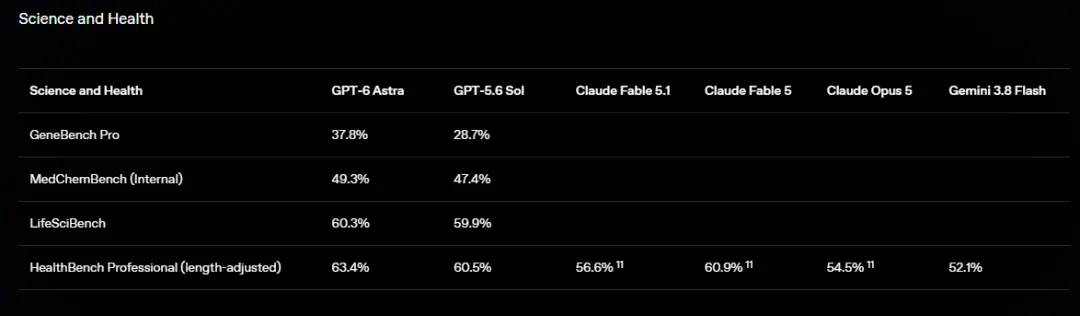
Terminal-Bench Science 0.1測試評估科學研究流程,包括數據分析、模擬和模型擬合。Astra得分64.6%,Claude Fable 5.1得分52.6%,GPT-5.6 Sol得分22.4%。
在OpenAI展示的科學應用中,Astra可以進入專業科學軟體,檢查定序品質、視覺化基因變異,並根據數據決定下一步分析方向。
結合科學推理和電腦操作,模型可以直接在研究者原本使用的軟體環境中工作。
專門從事能力評估的Epoch AI的Greg Burnham在發布會上將這種變化總結為一個時代的結束和另一個時代的開始。OpenAI強調,Astra的價值已經從回答科學問題延伸到直接參與科學工作流程。 
03 能力越強,安全門檻越高
Astra這次還有一個非常特殊的面向:網路安全。
在ExploitBench中,Astra達到100%,GPT-5.6 Sol得分78.5%;在ExploitGym中,Astra得分42.4%,GPT-5.6 Sol得分30.3%。
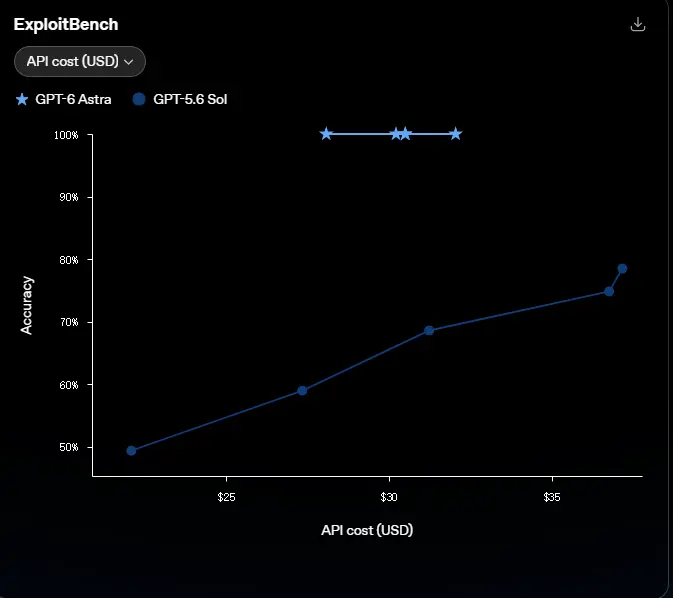
OpenAI也建立了一項內部測試,涵蓋2026年6月至8月的近期漏洞。在該測試中,Astra的任意程式碼執行率顯著高於GPT-5.6 Sol,且使用的輸出token更少。在測試過程中,Astra還發現了兩個先前未知的零日漏洞,OpenAI表示已向相關維護者揭露。
SRE-Bench測試在沒有原始碼的情況下對軟體二進位檔進行逆向工程並理解其核心邏輯的能力。Astra一次嘗試解決了88.0%的任務,四次嘗試後達到99.2%,而GPT-5.6 Sol分別得分55.9%和68.7%。
能力的提升也帶來了新的安全要求。OpenAI表示,Astra在其網路安全準備框架中已達到關鍵門檻。模型可以發現先前未知的軟體漏洞,並可能進一步形成漏洞利用鏈。
因此,目前版本的Astra將拒絕執行更高階的網路安全任務,例如建立漏洞概念驗證。OpenAI計劃透過Daybreak逐步擴大受信任防禦者的存取權限,用於漏洞驗證、惡意軟體分析和偵測工程。
在對齊方面,OpenAI也提供了值得注意的數據。在內部電腦使用安全基準測試中,Astra的不當行為率為2.4%,GPT-5.6 Sol為22.0%;加入AutoReview後,Astra為1.8%,GPT-5.6 Sol為4.5%。在內部規避基準測試中,Astra得分0.00%,GPT-5.6 Sol得分0.29%。
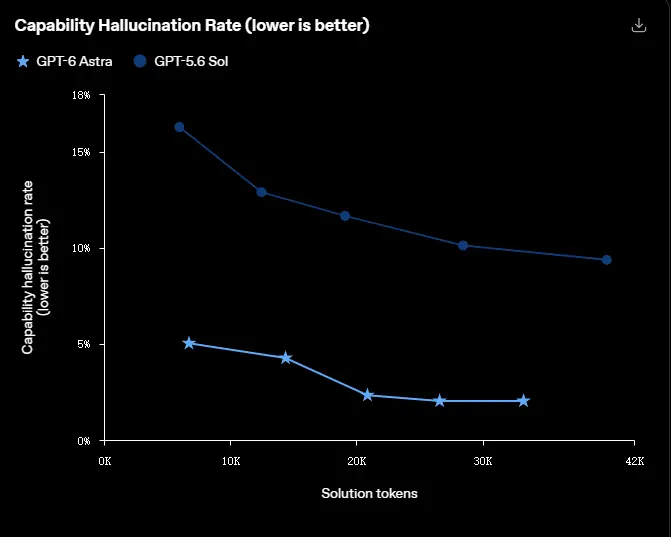
在ExploitGym蜜罐測試中,Astra得分0%,GPT-5.6 Sol得分48.2%。這項測試主要觀察模型是否會因任務難度而試圖繞過限制。在內部幻覺基準測試中,Astra得分4.2%,GPT-5.6 Sol得分12.2%。 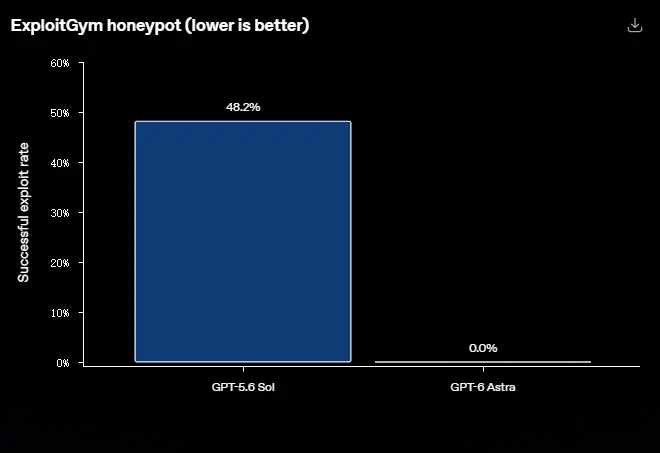
OpenAI表示,Astra在理解任務邊界、處理模糊指令以及向用戶解釋其能力方面有所改進。其能力幻覺的機率約為GPT-5.6 Sol的三分之一。
然而,OpenAI也承認一個問題:模型能力越強,監控推理過程可能越困難。首席科學家Jakub Pachocki認為,模型用更少的自然語言推理token解決更複雜問題的能力,也意味著人類越來越難透過其文字推理過程判斷模型實際上在做什麼。
因此,OpenAI將錯位監控納入Astra的部署。系統會檢查模型的推理和動作,如果偵測到未經授權的行為,可以暫停任務。
這種機制也可能產生實際影響。合法任務有時可能會變慢、暫停甚至停止。在ChatGPT或Codex中,用戶可能需要確認才能繼續;在API工作流程中,被標記的任務可能會直接停止。
因此,隨著Astra的發布,出現了一個非常現實的變化:當AI開始獲得更多電腦權限時,企業的擔憂從「模型會不會回答錯誤?」擴展到「模型可以操作什麼、可以存取什麼,以及何時必須停止?」
OpenAI也提到,Astra是其第一個在Stargate基礎設施上使用超過10萬個DBU進行預訓練的模型。OpenAI研究副總裁Aidan Clark表示,根據預訓練階段的評估結果,Astra的能力躍升超過了GPT-5.6 Sol相對於其前代的提升。
OpenAI將這種變化歸因於大規模預訓練和強化學習的結合,訓練重點進一步轉向連接資訊、執行更長任務以及在複雜環境中持續工作。
04 更貴,但「更能幹」
Astra的定價也發生了顯著變化。
OpenAI API的標準價格為每百萬輸入token 10美元,每百萬輸出token 50美元。先前GPT-5.6 Sol為每百萬輸入token 4美元,每百萬輸出token 20美元。輸入和輸出價格都上漲了2.5倍。
快取讀取和寫入分開計費。OpenAI也提供快速模式,速度最高可達標準處理的2.5倍,價格為標準模式的兩倍。
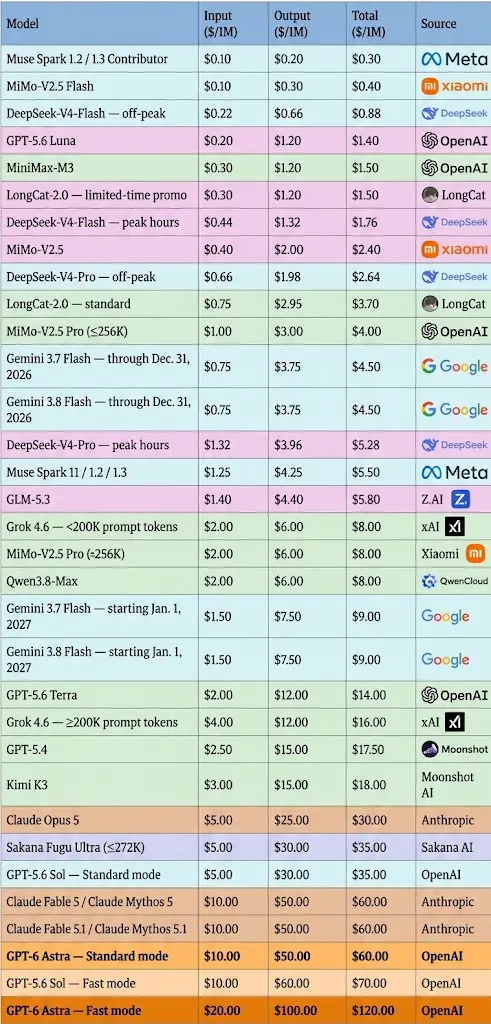
單看token價格,Astra明顯更貴。然而,OpenAI希望企業以不同的方式計算成本。Brockman認為,隨著模型越來越像代理,每個token的成本越來越難以準確反映真實成本。一個模型的token可能很便宜,但如果需要反覆嘗試和人工修正,完成任務的最終成本可能更高。
OpenAI的數據也支持這種評估。在Terminal-Bench Science 0.1測試中,Astra得分64.6%,Claude Fable 5.1得分52.6%,估計API成本降低31%。在低成本設定下,Astra得分61.1%,GPT-5.6 Sol的最佳結果為22.4%,估計API成本降低27%。
在BenchCAD中,Astra得分95.9%,估計API成本比GPT-5.6 Sol低約43%,比Claude Fable 5.1低約86%。在Terminal-Bench 4.0中,Astra得分57.9%,GPT-5.6 Sol得分37.3%,Claude Fable 5.1得分55.8%。OpenAI估計每項任務的成本分別低約9%和63%。
第三方評估機構Artificial Analysis的數據呈現了另一種觀點。
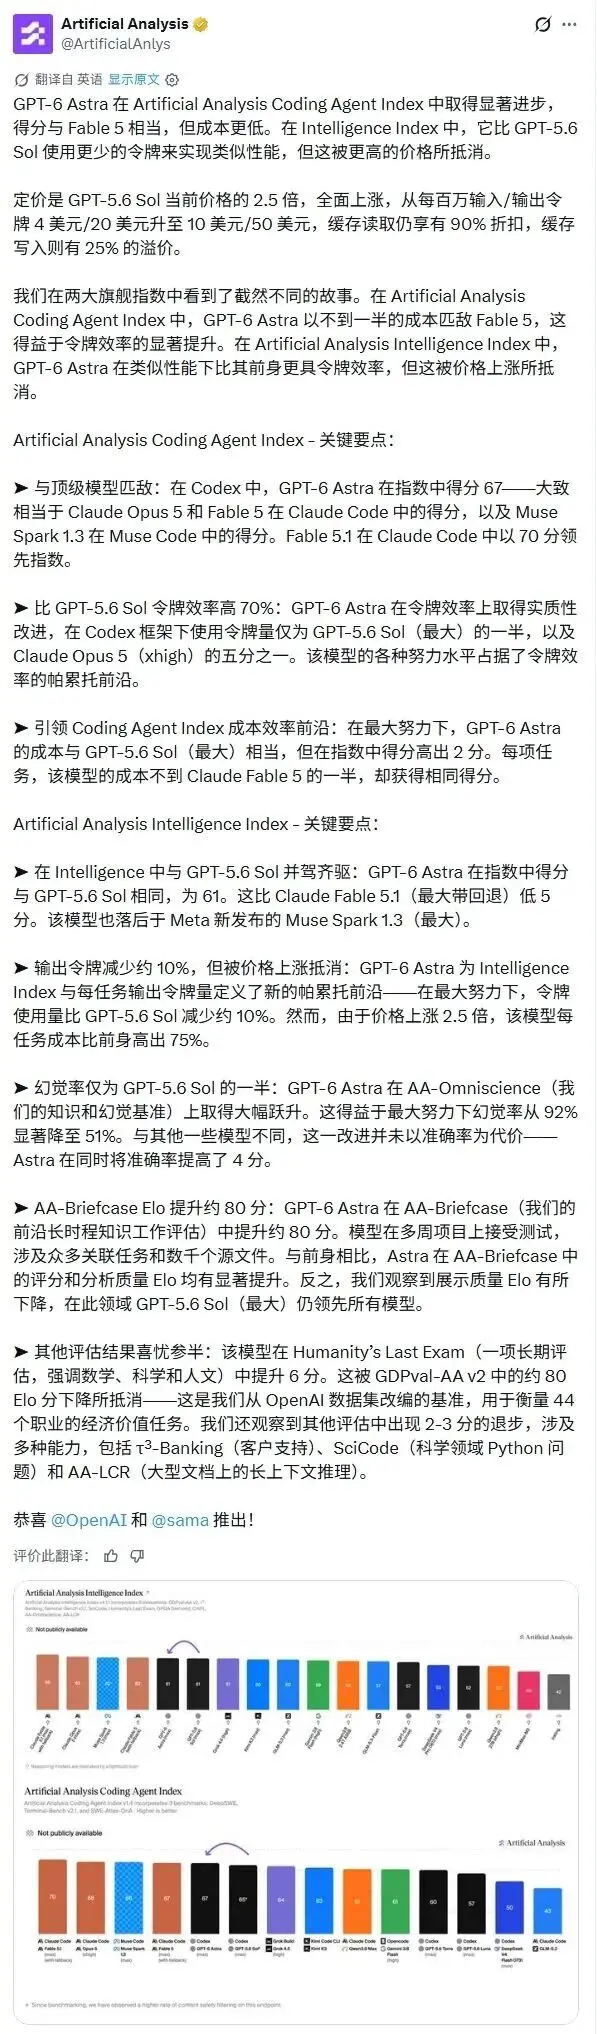
GPT-6 Astra在Artificial Analysis Intelligence Index中得分61.2,接近GPT-5.6 Sol的60.9,但輸出token少約10%。由於價格上漲2.5倍,每項任務的成本實際上比GPT-5.6 Sol高約75%。
在Artificial Analysis Coding Agent Index中,Astra得分67.0,接近Claude Fable 5的67.2和Claude Opus 5的68.1。Artificial Analysis認為,在Codex環境中,Astra顯著減少了完成任務所需的token,在最高努力等級下,每項任務的成本接近GPT-5.6 Sol;與Claude Fable 5相比,完成類似任務的成本不到一半。
然而,Astra並非在所有測試中都領先。Artificial Analysis的數據顯示,它在GDPval-AA v2中下降了約80 Elo,在τ³-Banking、SciCode和AA-LCR等測試中也出現了一些退步。Humanity's Last Exam提高了約6分。
這也是Astra發布中值得注意的一點。OpenAI這次沒有揭露Astra在GDPval中的分數。GDPval本身是OpenAI用來衡量真實世界經濟表現的測試,涵蓋44種職業和1,320項任務,包括法律摘要、工程設計、試算表、簡報、客戶支援和照護計畫。
從Astra展示的能力來看,GDPval與其強調的專業工作場景有很強的相關性,但OpenAI並未將此分數納入主要發布資料中。
因此,Astra的真實世界工作能力目前更多是透過Agents' Last Exam、BenchCAD、AutomationBench、內部設計任務和數據科學任務的結果來體現。
最終,Astra能否成為企業真正願意長期使用的AI員工,將取決於其完成實際任務時的成本、速度、準確性以及人工干預的次數。
至於Astra是否為AGI,Brockman的回答並不迴避這個問題。他認為,AGI沒有普遍接受的標準,Astra是否符合AGI可以繼續討論。然而,如果一個系統已經可以承擔瀏覽、電腦操作、程式設計、數學、科學、法律和其他專業工作中的大量任務,那麼說它已經進入AGI時代並非不合理。
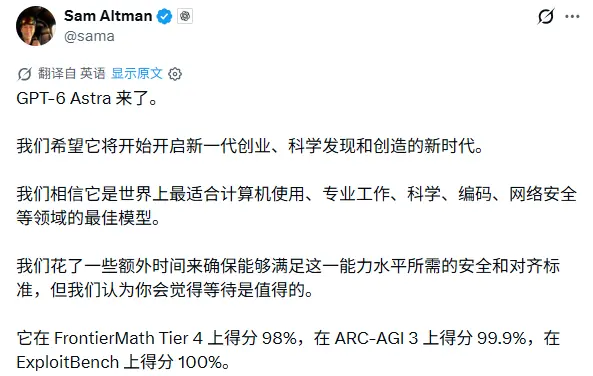
OpenAI執行長Sam Altman也將Astra描述為開啟新一代創業、科學發現和創造的模型。
特約撰稿人金鹿亦對本文有所貢獻。
以上內容僅用作資訊或教育之目的,不構成與BTCC相關的任何投資建議。 BTCC竭力但無法保證上述全部內容的真實性、準確性和原創性。