


Claude 5.1 正式發布!地表最強模型登場
 chaincatcher
原文追蹤 AI 的機器之心
就在剛才,Anthropic 推出了下一代模型 Claude Fable 5.1 和 Claude Mythos 5.1。
Anthropic 聲稱,Claude Fable 5.1 是目前最強大的公開可用模型之一,專為複雜推理、長時間任務和代理工作流程而設計。Claude Mythos 5.1 則代表了他們對更高能力邊界的探索。
值得注意的是,雖然兩者共享相同的基礎模型能力,但針對不同的使用場景採取了不同的安全措施。
Fable 5.1 向一般使用者、開發者和企業開放,而 Mythos 5.1 則針對經過審查的高風險領域合作夥伴,維持更嚴格的存取控制。
換句話說,一個負責進入現實世界的任務,另一個則被保留在更嚴格控制的環境中。這可能也是 Anthropic 對 AI 產品未來形態的探索:最強的模型不一定以相同形式提供給所有人。
官方聲明指出,這兩個模型代表了 Claude 系列能力的重大進步,並展示了他們如何在提升模型能力的同時,持續推進安全部署。
作為「地表最強」的模型,Fable 5.1 的表現依然令人印象深刻。官方數據顯示,Fable 5.1 在多項基準測試中超越了前代旗艦 Fable 5。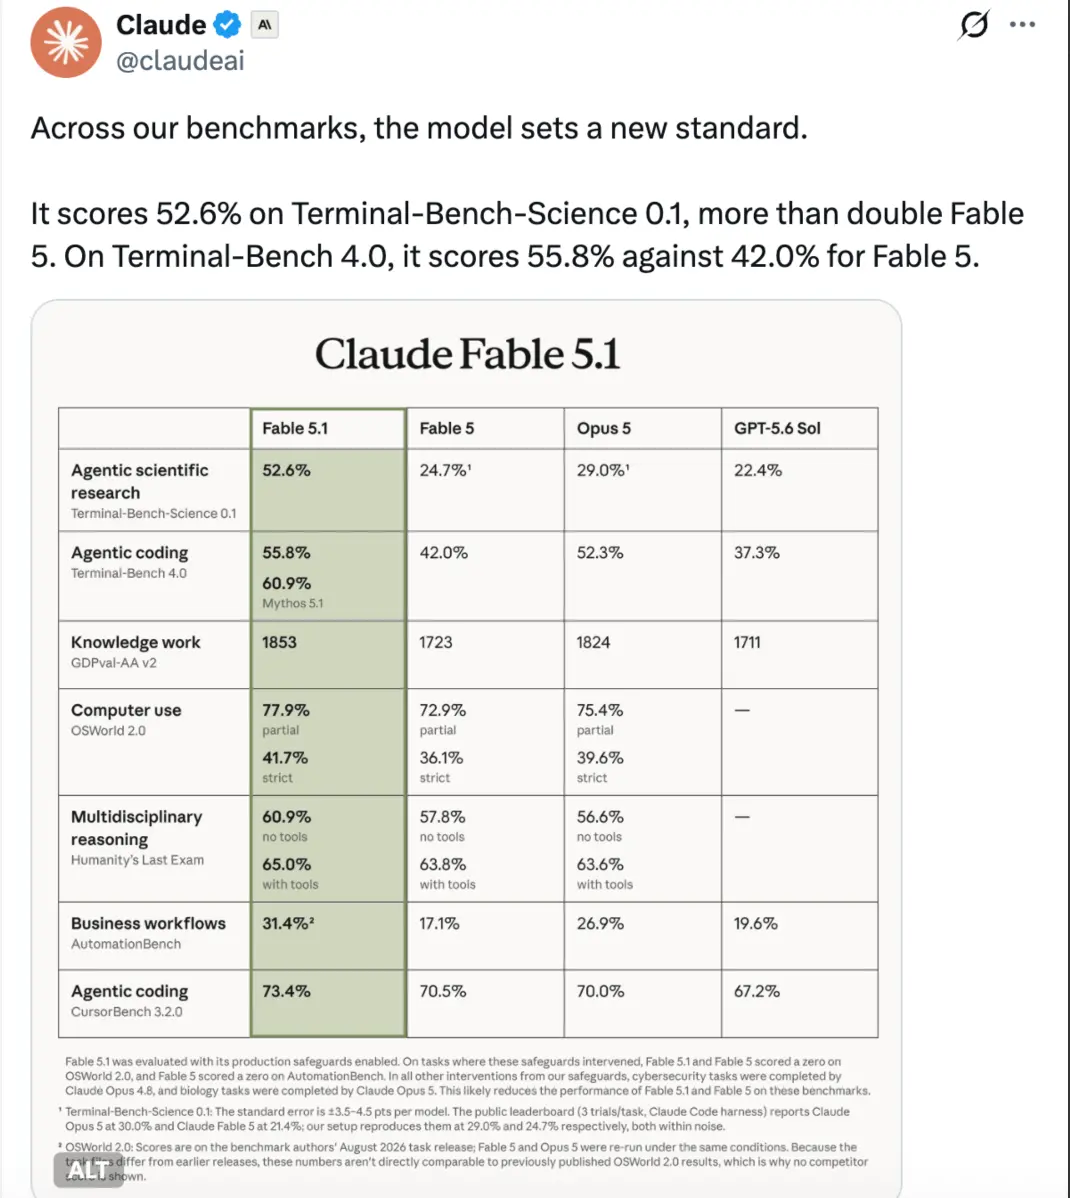
然而,能力更強的同時,價格卻下降了。Anthropic 表示,Fable 5.1 維持相同的基本價格,但快取讀取成本比 Fable 5 降低了 75%。在實際使用中,這使得典型工作負載的整體成本降低了約 25%;對於高度代理化的工作負載,成本最多可降低 45%。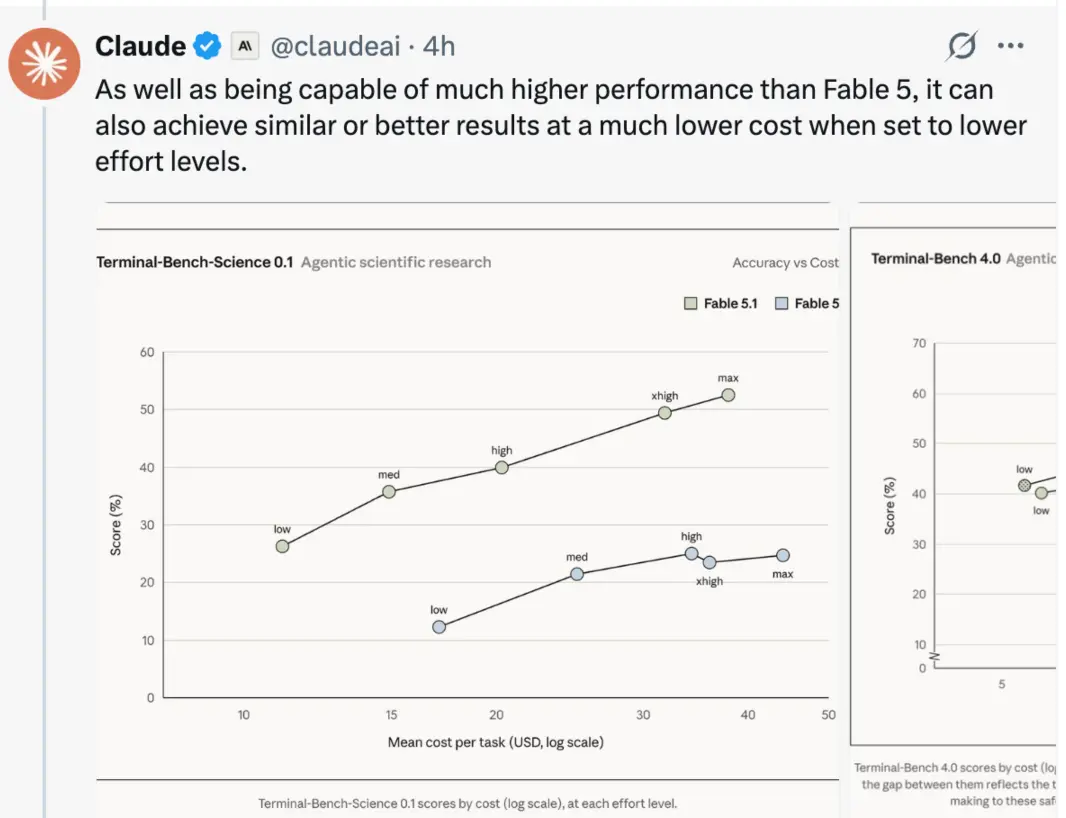
看來,即使是最強大的模型也開始注重性價比。
讓我們仔細看看。
低階追上前代,Fable 5.1 主打「性價比」
與其單純刷新排行榜,Anthropic 這次想強調的是:Fable 5.1 能以更低的推理成本,完成以往需要 Fable 5 高階才能完成的任務。
根據官方測試,Fable 5.1 在中低推理強度下,已經達到接近甚至超越 Fable 5 的表現。Claude Code 預設使用高推理強度,而 Claude Cowork 和 Claude .ai 預設為中等強度,讓使用者能根據任務複雜度在速度、成本和效果之間進行調整。
具體來說,Fable 5.1 在科學研究代理基準 Terminal - Bench - Science 0.1 中取得了 52.6% 的分數,比 Fable 5 的 24.7% 提高了一倍以上;在 Terminal - Bench 4.0 中,Fable 5.1 達到 55.8%,而能力更強的 Mythos 5.1 進一步達到 60.9%。
在知識工作、電腦操作和業務流程測試中,新模型也展現了進步。AutomationBench 分數從 Fable 5 的 17.1% 提升至 31.4%,CursorBench 3.2.0 則從 70.5% 提升至 73.4%。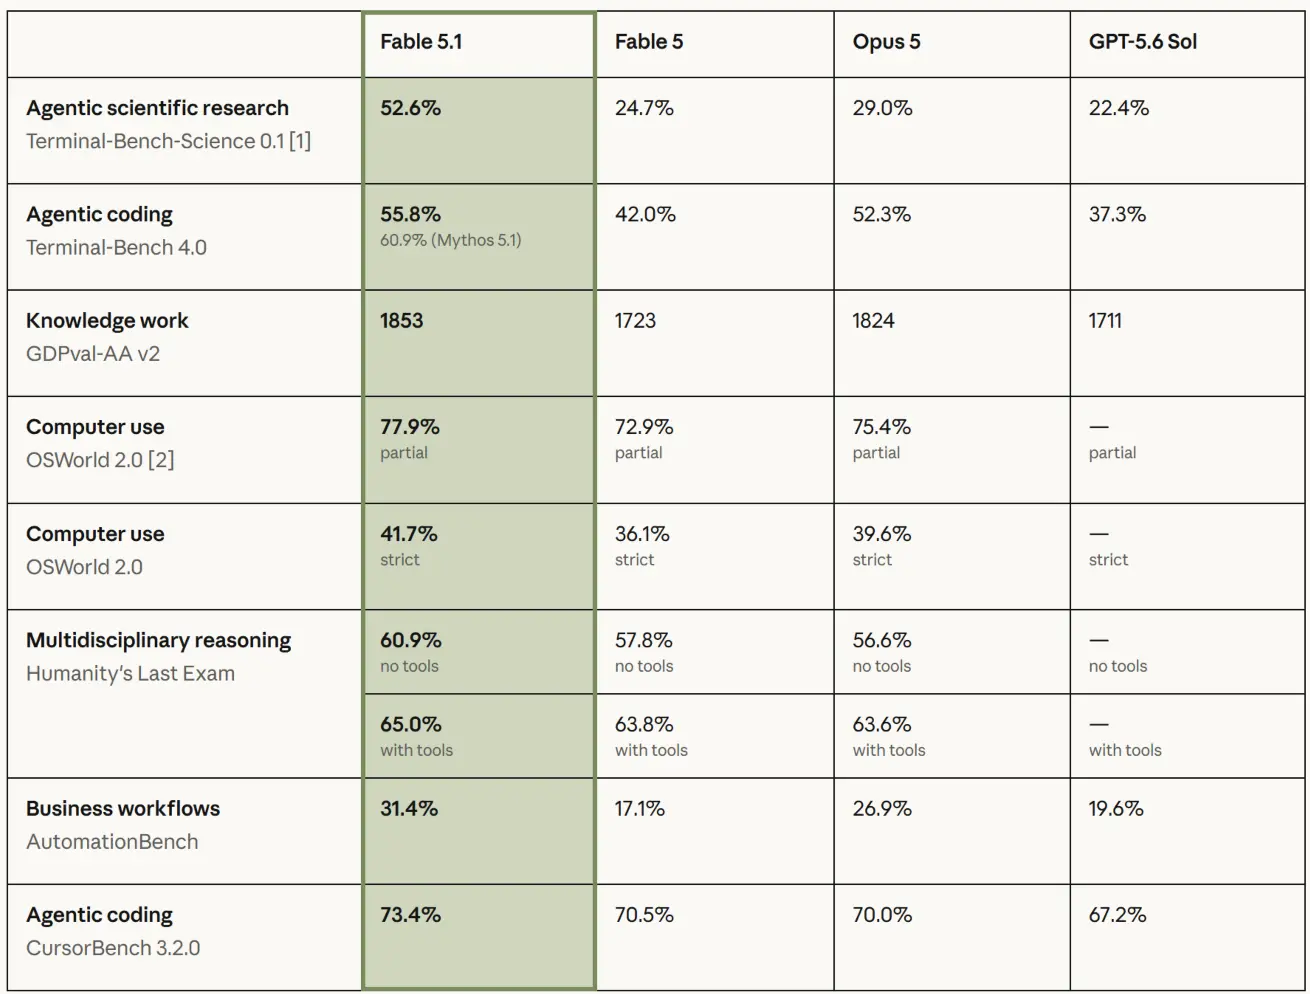
在多項基準測試中,Fable 5.1 的分數都超過了 Fable 5,其中科學研究代理和業務工作流程能力的提升最為顯著。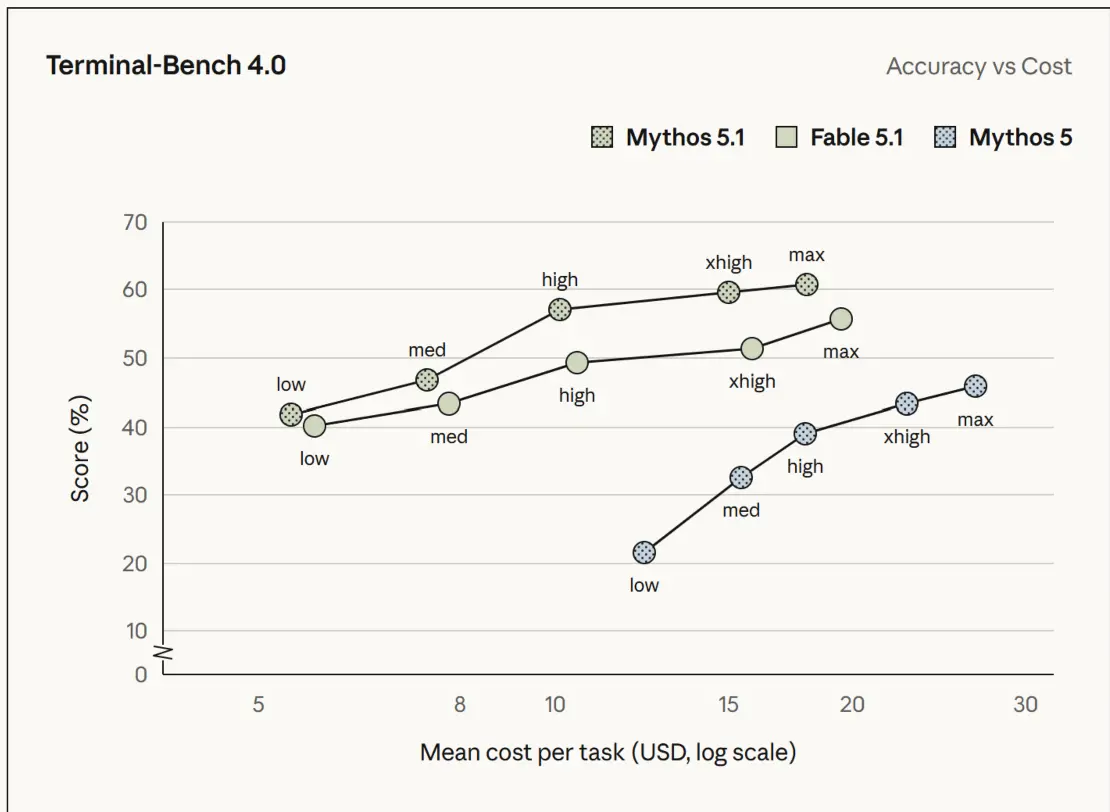
在 Terminal - Bench 4.0 測試中,Fable 5.1 和 Mythos 5.1 在不同推理強度下都超越了前代 Mythos 5。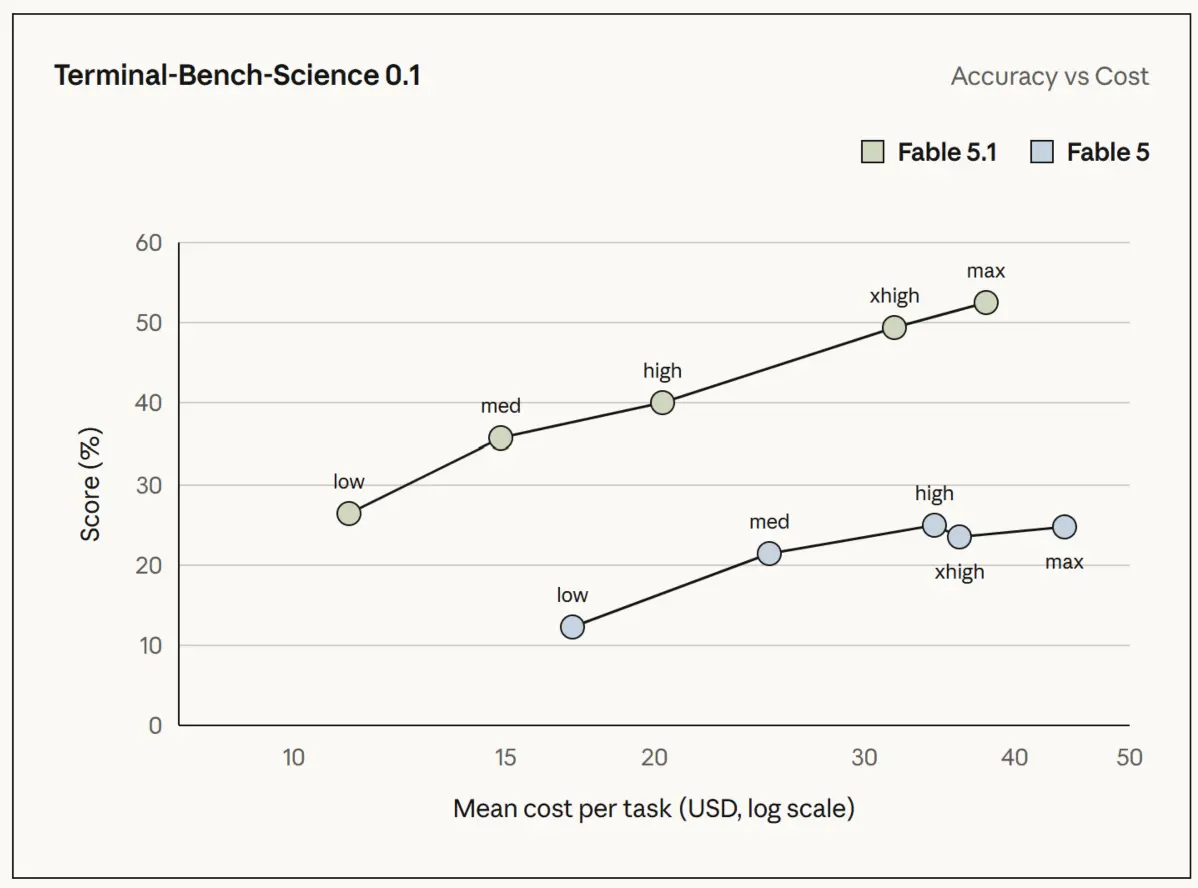
在 Terminal - Bench - Science 0.1 測試中,Fable 5.1 取得了最高 52.6% 的分數,是 Fable 5 的兩倍以上。
Anthropic 認為,Fable 5.1 的一個重要變化是更願意追蹤問題的根本原因,使其更適合執行持續數小時甚至數十小時的複雜任務。
投資公司 Millennium 在測試中發現,一段內部程式碼大約每執行一百萬次就會崩潰一次。這個問題困擾了工程團隊四到五年,其他模型都未能找出原因。Fable 5.1 透過反組譯外部供應商的程式庫並比對核心轉儲檔案,將問題定位到第三方程式庫中的一個錯誤。
Ramp 也讓 Fable 5.1 連續運行了 38 小時。在發現原始機器學習結果受到標註錯誤影響後,模型自主修正了問題,並同時啟動了六組實驗,最終編譯出新的結果和後續建議。
從寫程式到做科學研究
在這次發布中,Anthropic 用了相當大的篇幅討論 Fable 5.1 和 Mythos 5.1 在科學研究中的表現。
在蛋白質設計實驗中,研究人員讓 Mythos 5.1 呼叫開源的蛋白質設計和折疊工具,然後將生成的設計發送給兩個外部機構進行實驗驗證。
針對三個目標蛋白,Mythos 5.1 設計的配體結合親和力達到了 Adaptyv Bio 相關蛋白質設計競賽中最佳方案的十倍。在面對十二個目標蛋白時,模型的有效配體命中率接近 50%,而 Anthropic 提供的業界常見水準為 10% 至 15%。
Fable 5.1 也利用了 NASA 麥哲倫號太空船在 30 多年前收集的雷達影像,為金星表面約三分之一的面積生成了新的高解析度海拔地圖。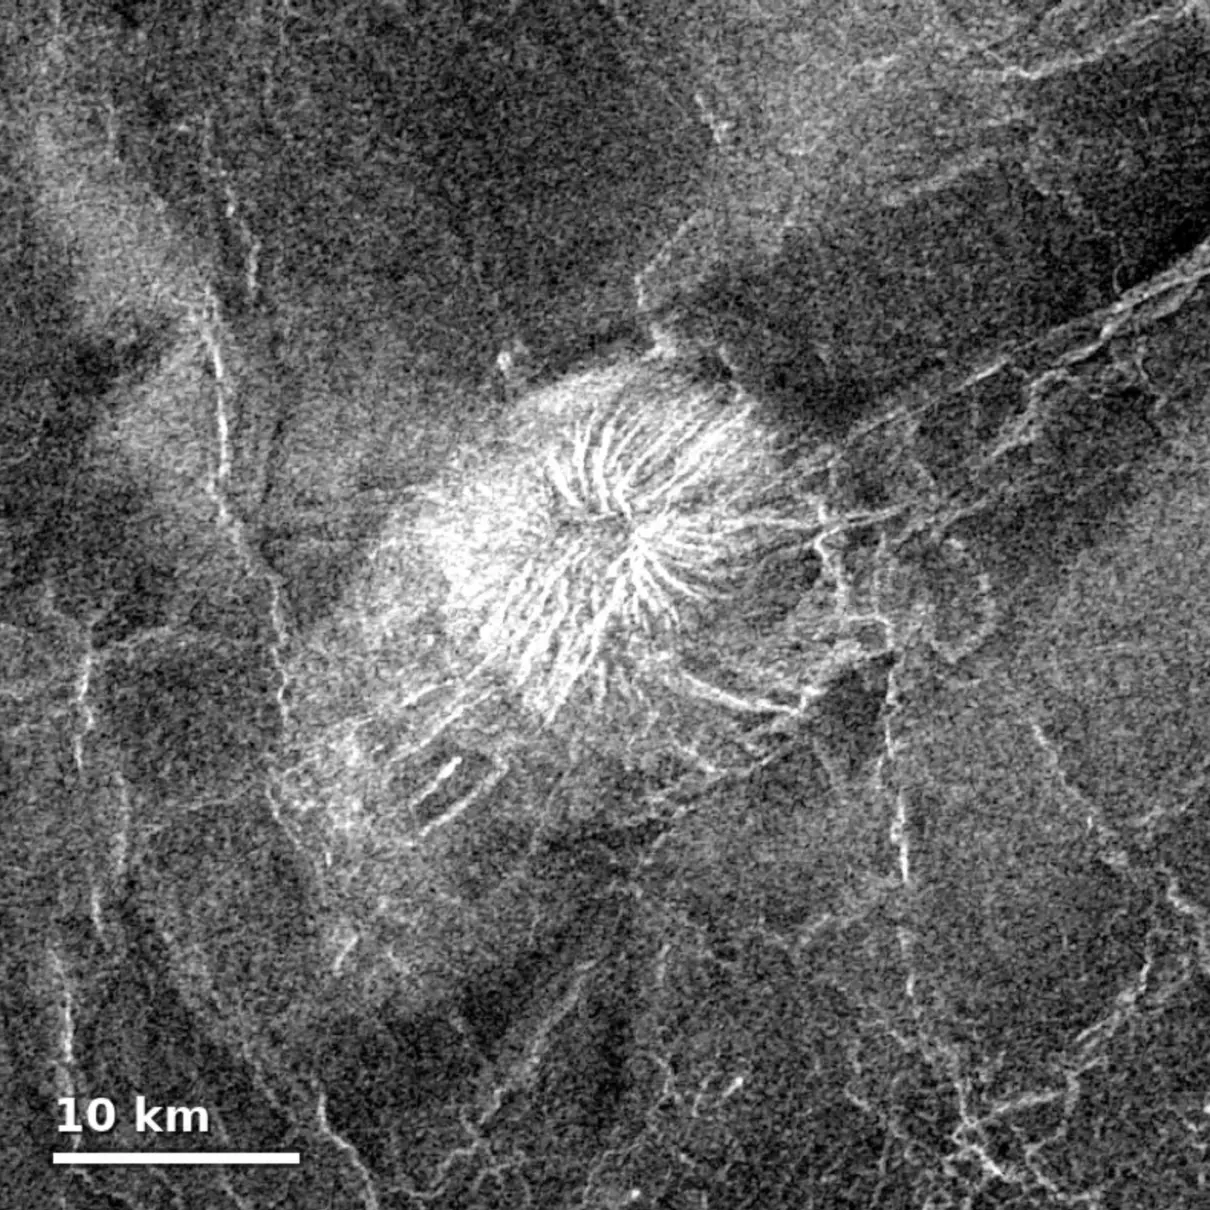
NASA 麥哲倫號太空船拍攝的金星雷達影像,中央是一座直徑約 15 公里的小型盾狀火山。
原始地圖只能呈現 10 至 20 公里尺度的細節,而新地圖將解析度提升至 2 至 3 公里,高度測量精度最高提升了 25%。Anthropic 計劃以知識共享授權公開這張地圖,供 NASA 的 VERITAS 和歐洲太空總署的 EnVision 等未來任務使用。
在計算生物學領域,Mythos 5.1 透過編寫自訂 GPU 核心和快取中間結果,將七個開源蛋白質和基因組深度學習模型的運行速度提升了最高 2.5 倍,同時保持輸出結果一致。在某些全基因組分析任務中,預計可將 GPU 成本降低 30% 至 60%。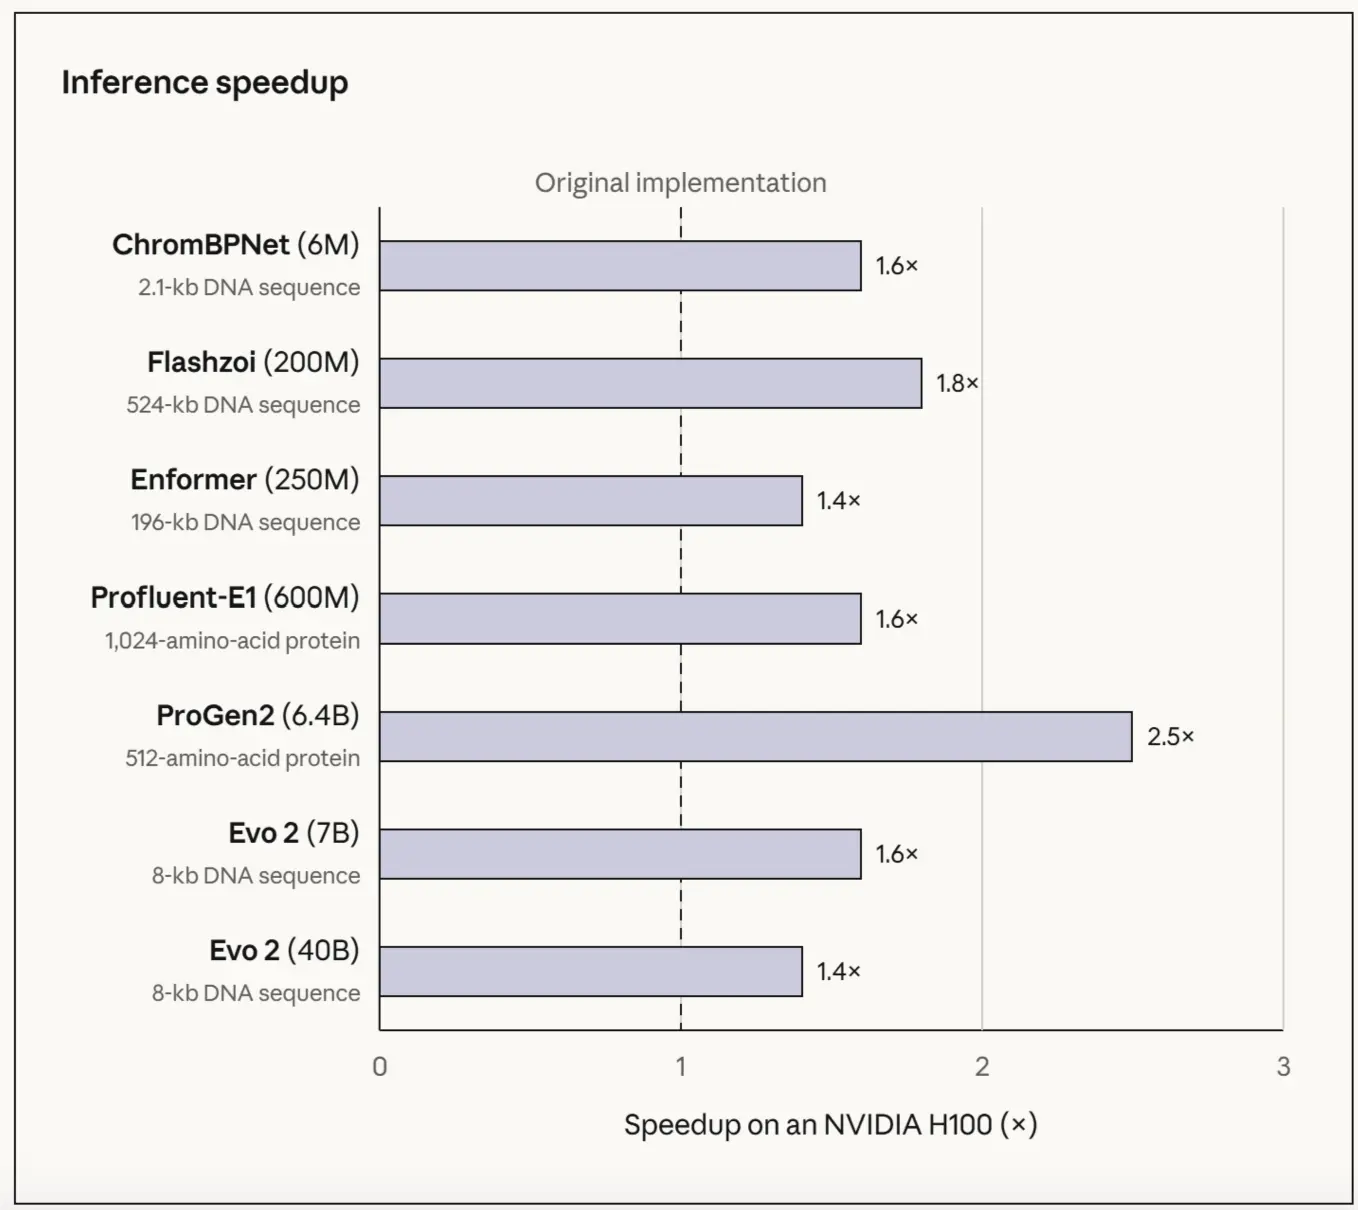
在優化七個開源蛋白質和基因組模型後,Mythos 5.1 的推理速度提升了 1.4 至 2.5 倍。
Anthropic 旨在利用這些案例展示,模型正在從整理資訊和編寫程式碼,演進到提出解決方案、執行工具,並交付可經實驗驗證的研究成果。
快取價格下降 75%,代理任務成本最多降低 45%。
除了效能之外,價格是 Fable 5.1 最直接的變化。
Fable 5.1 的輸入和輸出價格沒有調整,維持在每百萬個 token 10 美元和 50 美元,但快取讀取價格降低了 75%,降至每百萬個 token 0.25 美元。
快取讀取是指模型重複使用已處理過的上下文。在一般的問答中,其比例可能有限,但在需要反覆讀取程式碼庫、歷史對話和工具結果的代理任務中,快取往往構成主要成本。
根據 Anthropic 基於 2026 年 8 月實際使用數據的計算,使用 Fable 5.1 運行典型任務的整體成本比 Fable 5 低約 25%;對於上下文更長、工具呼叫更頻繁的複雜代理任務,成本降低幅度最高可達約 45%。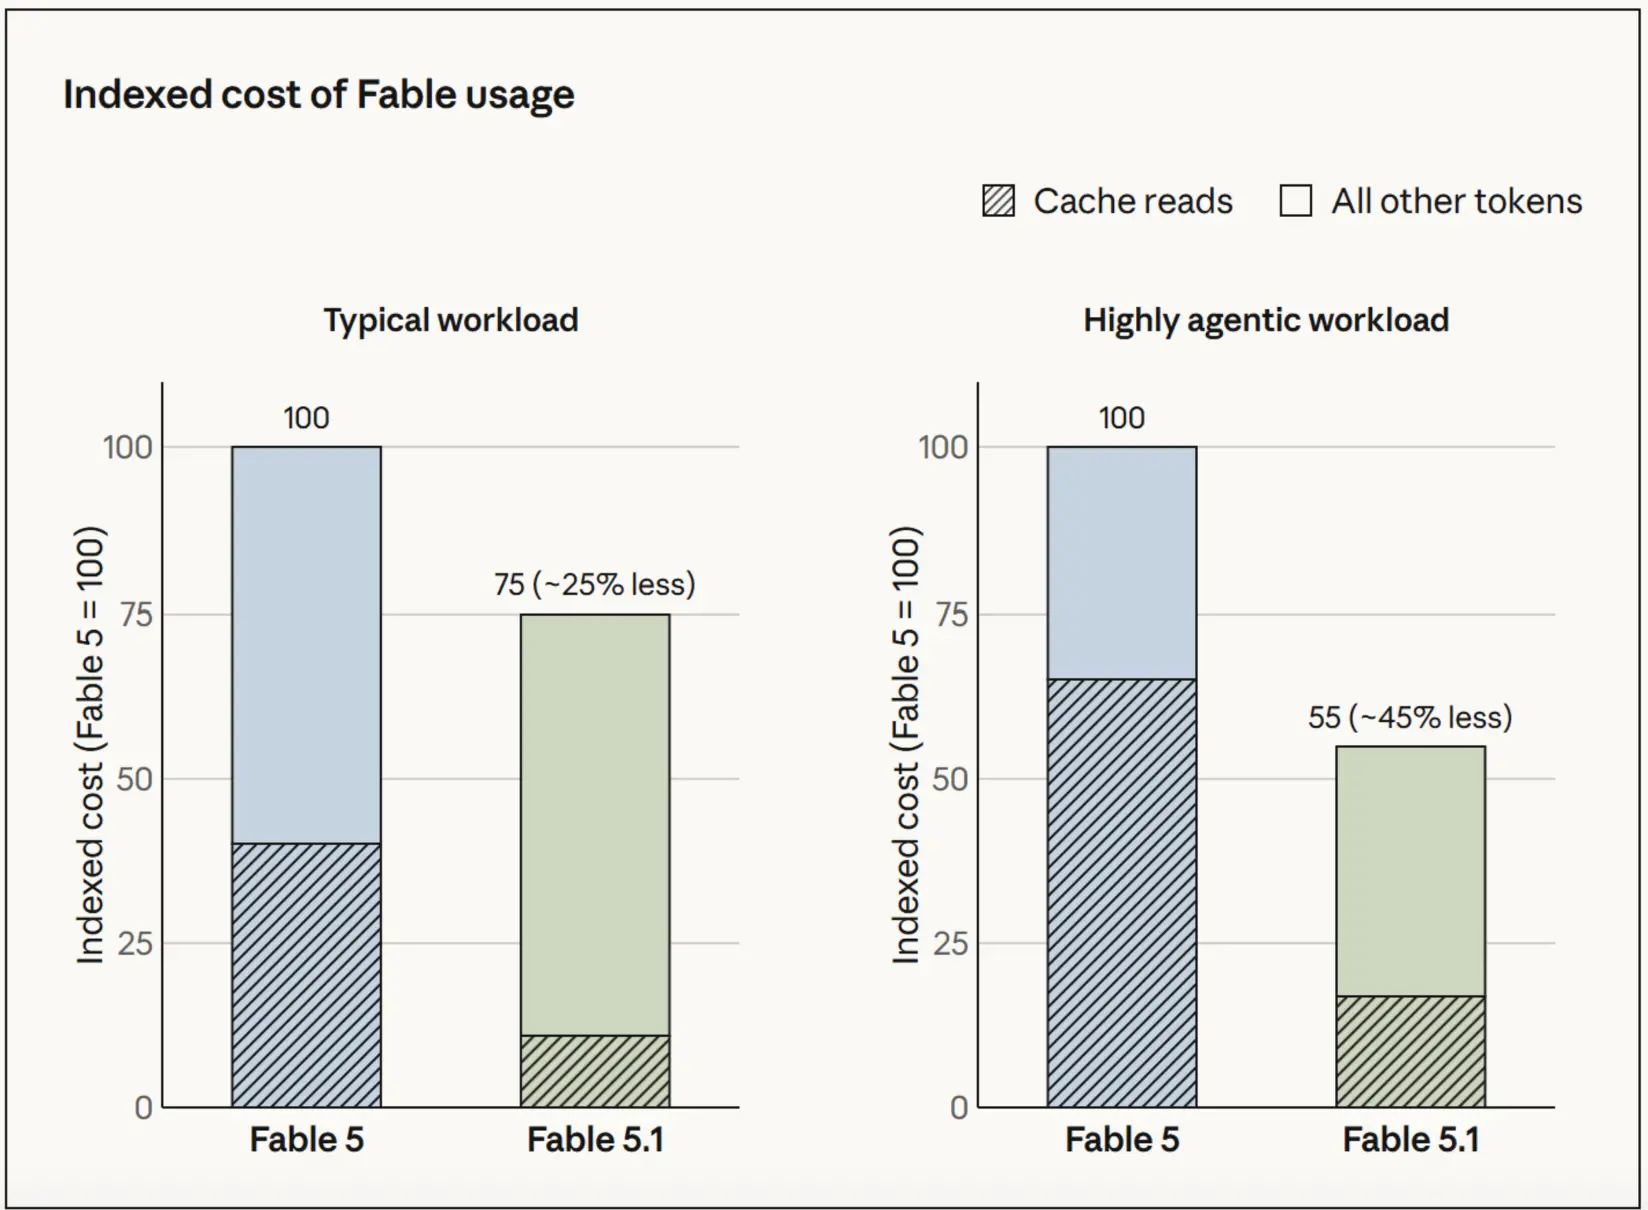
在快取讀取價格降低後,Fable 5.1 的典型任務成本降低了約 25%,而高度代理化任務的成本最多降低了約 45%。
Fable 5.1 現已在 Claude .ai、Claude Code 和 Claude API 上提供,並透過 AWS、Google Cloud 和 Microsoft Azure 提供。開發者可以透過 claude - fable -5-1 呼叫新模型。
強化反蒸餾機制
Fable 5.1 和 Mythos 5.1 實際上使用相同的底層模型,主要差異在於安全限制。
Fable 5.1 完全向一般使用者和企業開放;Mythos 5.1 則在網路安全和生命科學方面的限制較為寬鬆,目前僅提供給經過審查的個人和機構。
在網路安全領域,Fable 5.1 已經可以幫助使用者發現軟體漏洞,但仍無法直接生成攻擊程式。滲透測試、攻擊程式生成和基於二進位檔的漏洞掃描等雙重用途任務,可能仍需交由限制更嚴格的模型處理。
經過調整後,新版的網路安全保護機制與 Fable 5 相比,誤報率降低了約 60%。生物安全機制在基礎生物學和醫療問題上的誤報率也下降了 85%,而與生命科學研究相關的進階能力主要透過 Mythos 5.1 審查計畫開放。
Anthropic 也推出了 Enterprise Frontier Safeguards。企業可以將資料儲存在其控制的雲端基礎設施中,由企業負責預設的人工審查,從而在保留安全監控能力的同時,實現近乎「零資料留存」的隱私效果。這項機制計劃從今年秋季開始分階段推出。
針對大規模模型蒸餾,Fable 5.1 也增加了新的限制。當天之後建立的 API 帳戶,將無法在多輪對話中手動修改先前的上下文,同時保留 Claude 的歷史思考記錄。Anthropic 表示,這項變更主要是為了阻止一種公開已知的能力提取方法。
此外,為了符合歐盟《人工智慧法案》的要求,Fable 5.1 的文字輸出將包含隱形浮水印。Anthropic 也開始小規模測試偵測 API,初期開放給監管機構、媒體、事實查核組織和研究機構。
最後,網友說得對,早起的鳥兒先用上 5.1。
以上內容僅用作資訊或教育之目的,不構成與BTCC相關的任何投資建議。 BTCC竭力但無法保證上述全部內容的真實性、準確性和原創性。