


'AGI 시대에 오신 것을 환영합니다': OpenAI, GPT-6 Astra 공개
 chaincatcher
글 | 텐센트 테크놀로지 샤오징
"AGI 시대에 오신 것을 환영합니다."
OpenAI 공동 창립자 겸 사장 그렉 브록먼(Greg Brockman)은 이 말로 GPT-6 Astra의 출시를 요약했습니다.
미국 현지 시간 9월 3일, OpenAI는 GPT-6 Astra를 공식 출시했습니다. 기존 모델이 주로 답변, 생성, 도구 호출을 담당했던 것과 달리, Astra는 한 단계 더 나아가 지시 수신, 소프트웨어 조작, 결과에 따른 후속 조치 조정까지 전체 작업을 지속적으로 실행할 수 있습니다. 이것이 OpenAI가 'AGI 시대'를 다시 제시한 이유 중 하나입니다.
OpenAI는 Astra를 '세계에서 가장 강력한 컴퓨터 사용 모델'로 포지셔닝했습니다. 이 능력은 브라우징, 이메일, 스프레드시트와 같은 간단한 작업에서 Power BI, KiCad, FreeCAD와 같은 전문 소프트웨어로 확장되어 데이터 분석, 엔지니어링 설계, 소프트웨어 테스트, 문제 해결 등 더 복잡한 워크플로우에 진입하기 시작했습니다.
OpenAI가 공개한 영상에서 Astra는 간단한 그래픽에서 시작하여 3D 게임, 제품 페이지 등의 작업을 지속적으로 완료할 수 있습니다. OpenAI는 회로 기판 설계, Blender 모델링, 법률 문서, Excel, 과학 분석 등의 예시도 제공했습니다. 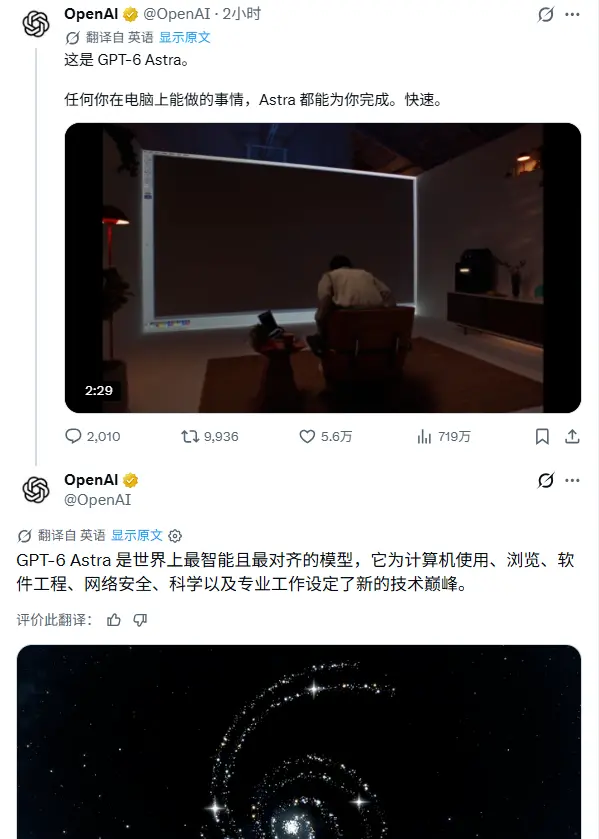
OpenAI가 발표한 여러 벤치마크 테스트 결과에 따르면, 능력 향상은 컴퓨터 조작, 장기 코딩, 엔지니어링 설계, 과학 연구와 같이 지속적인 행동이 필요한 작업에 집중되어 있습니다. Astra는 ExploitBench에서 100%를 달성했으며, 컴퓨터 조작 및 CAD 관련 테스트에서 이전 세대 모델을 크게 능가했습니다.
현재 Astra는 일부 기관에 공개되었으며, 앞으로 며칠 내에 ChatGPT Plus, Pro, Business, Enterprise 사용자에게 점진적으로 제공될 예정입니다. OpenAI API와 Amazon Bedrock을 통해서도 사용할 수 있습니다. 표준 API 가격은 입력 토큰 백만 개당 10달러, 출력 토큰 백만 개당 50달러로, GPT-5.6 Sol의 2.5배입니다.
01 먼저 AI에게 '컴퓨터 사용'을 가르치다
Astra가 강조하는 가장 큰 변화는 '컴퓨터 사용'입니다. 과거에는 사용자가 AI를 특정 소프트웨어에 연결해야 작업을 완료할 수 있었습니다. 기업은 API, 플러그인, 검색 시스템, 다양한 커넥터를 개발해야 모델이 내부 도구를 호출할 수 있었습니다.
Astra는 일부 작업을 건너뛰려고 시도합니다. 컴퓨터 화면을 직접 보고 마우스, 키보드, 브라우저를 사용하여 작업을 완료할 수 있습니다. OpenAI가 제공한 예시에는 온라인 양식 작성, CRM 고객 기록 업데이트, 일정 관리, 웹 검색, 검색 결과를 이메일이나 문서로 정리하는 것이 포함됩니다.
또한 Python 노트북을 열어 과학 데이터를 분석하고, Power BI에서 데이터를 처리하고, KiCad와 FreeCAD를 사용하여 엔지니어링 설계를 완료하고, 웹사이트를 구축하고 프런트엔드 테스트를 수행하며, 소프트웨어를 설치하고 오류를 확인하고 화면에 나타나는 문제를 처리할 수 있습니다.
OpenAI는 Astra가 KiCad에서 PCB 레이아웃을 완료하는 모습을 시연했습니다. 모델은 전자 회로도에서 시작하여 회로 기판에 부품을 배치한 다음 구리 배선을 완료합니다. 전체 과정은 15초로 압축되었습니다. 엔지니어에게는 과거에 수동으로 수행해야 했던 이러한 작업을 이제 모델이 실행할 수 있습니다. 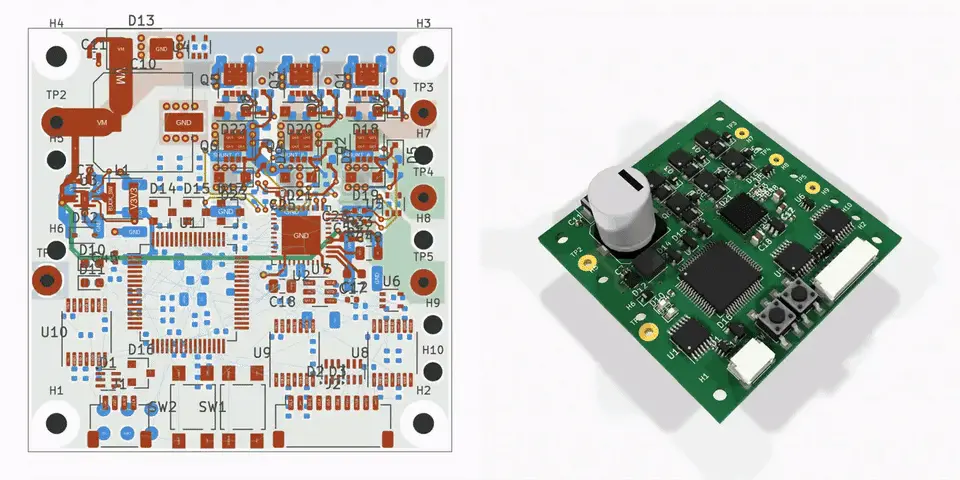
또 다른 시연은 Blender와 Unreal Engine 5에서 3D 모델링을 완료하는 것입니다. Astra는 먼저 Blender에서 집을 만든 다음 모델을 Unreal Engine 5에서 걸어 다닐 수 있는 장면으로 변환하여 디자이너와 고객이 미리 장면에 들어가 공간을 확인할 수 있게 합니다. 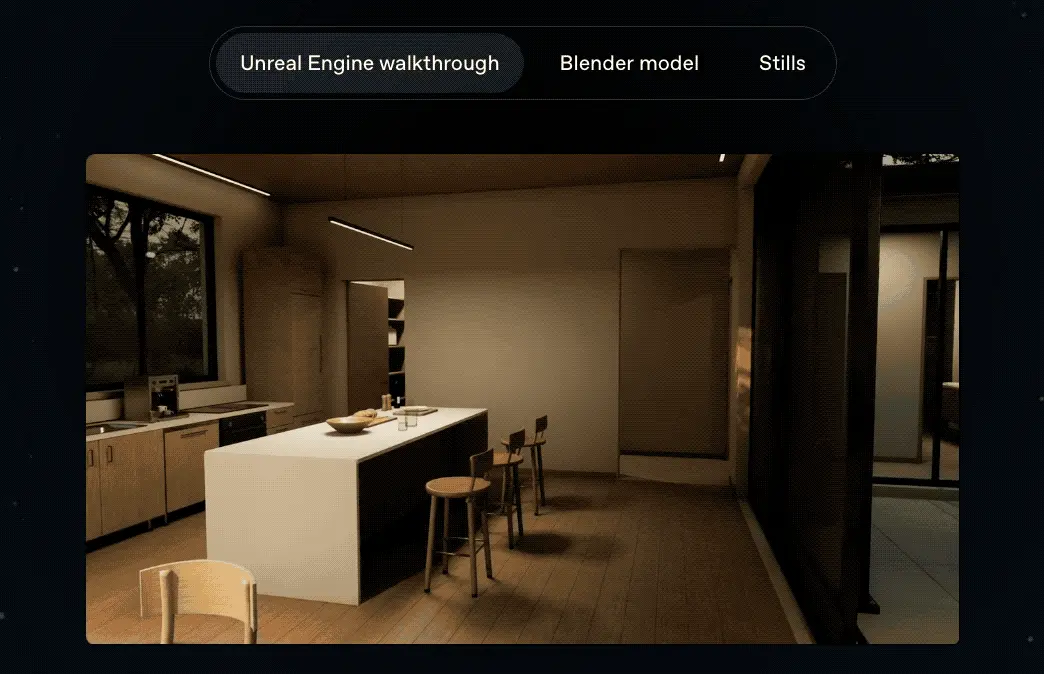
OpenAI는 게임 개발, Excel, Power BI, 자동차 변속기, 법률 문서, 1040 양식 등의 시나리오도 시연했습니다.
OSWorld 2.0 오프라인 하위 집합 테스트에서 Astra는 72.6%를 기록했고, GPT-5.6 Sol은 65.7%를 기록했습니다. 실제 지연 시간을 시뮬레이션한 후 OpenAI는 Astra가 작업당 평균 약 40분이 걸리는 반면 GPT-5.6 Sol은 약 75분이 걸려 시간이 약 47% 단축되었음을 발견했습니다.
Agents' Last Exam에서 Astra는 59.3%, GPT-5.6 Sol은 53.6%, Claude Opus 5는 55.5%를 기록했습니다. 또한 최고 점수 설정에서 Astra가 사용한 출력 토큰은 Claude Opus 5보다 약 65% 적었습니다.
ScreenSpot-Pro 점수는 92.7%에 도달했고, GPT-5.6 Sol은 76.9%였습니다.
속도도 향상되었습니다. OpenAI는 Codex 프레임워크를 동시에 업데이트했으며, Astra와 결합했을 때 Mind2Web 테스트에서 작업 완료 속도가 현재 GPT-5.6 Sol 경험의 1.9배에 달했습니다.
공식 시연에는 소아과 의사 검색, 아파트 찾기, DMV 예약, 저탄수화물 간식 찾기, 유치원 분석 등 몇 가지 일상적인 시나리오도 포함되었습니다. 시연에서 Astra는 2분 54초 만에 작업 하나를 완료했습니다.
투자자이자 AI 실무자인 Matt Shumer는 X에 경험을 공유했습니다. 그는 Astra에게 Unreal Engine에서 세계를 만들게 한 다음 Astra가 구동하는 인간 에이전트를 추가하여 이 에이전트들이 공존하게 했습니다.
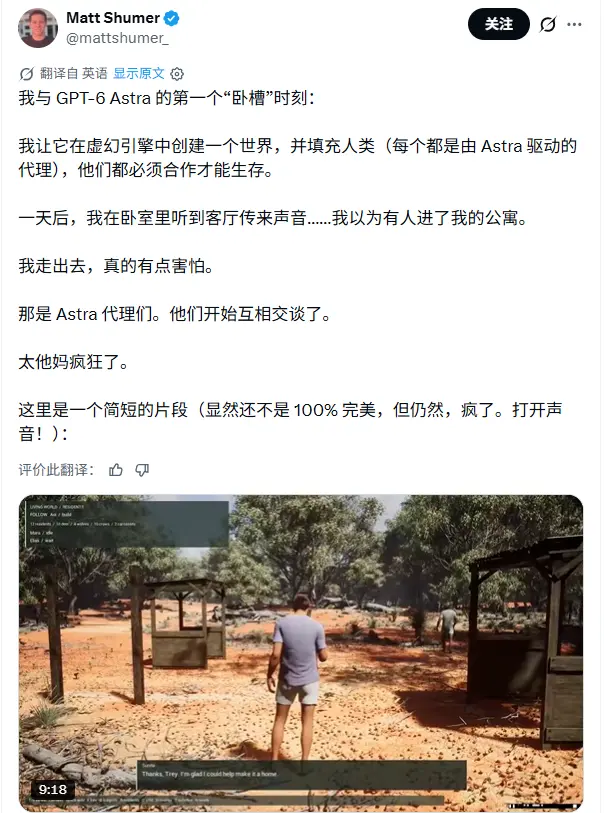
하루 후, 그는 침실에서 거실에서 들려오는 소리를 듣고 처음에는 누군가 아파트에 침입했다고 생각했습니다. 나중에 그 소리가 Astra 에이전트들이 서로 의사소통을 시작한 것임을 알게 되었습니다.
이러한 경험은 아직 완전히 안정적이지 않지만, Shumer는 여러 AI 에이전트가 동일한 가상 세계에 들어가 자율적으로 상호 작용하는 효과가 그를 놀라게 하기에 충분했다고 생각합니다.
Cognition 수석 연구 부사장 Silas Alberti는 회사가 출시 당일 Astra를 Devin 프레임워크에 통합할 계획이라고 밝혔습니다. 내부 테스트에서 Astra는 컴퓨터 사용, 작문, 코드베이스 이해 능력이 크게 향상되었고, 비디오 이해가 더 명확해지고 보고서가 더 간결해졌습니다.
02 코드 작성에서 전체 작업 완료까지
컴퓨터 사용 능력이 강화된 후 Astra가 다루는 작업 범위는 더욱 확대되었습니다. OpenAI는 이를 소프트웨어 엔지니어링, 전문 작업, 과학 연구를 위한 모델로 포지셔닝했습니다. 더 긴 작업을 처리할 수 있고 작업 변화에 따라 작업 방향을 조정할 수 있습니다.
이 능력은 코딩 테스트에서 특히 두드러집니다.
Terminal-Bench 4.0 테스트에서 Astra는 57.9%, GPT-5.6 Sol은 37.3%, Claude Fable 5.1은 55.8%를 기록했습니다.
DeepSWE v1.1에서 Astra는 74.1%, GPT-5.6 Sol은 72.7%를 기록했습니다. 내부 데이터베이스 마이그레이션 작업에서 Astra는 63.9%, GPT-5.6 Sol은 42.7%를 달성했습니다.
Astra는 또한 긴 Codex 작업에 대한 개선 사항을 적용했습니다.
과거에는 긴 작업이 컨텍스트 창 제한에 도달하면 모델이 일반적으로 이전 작업을 요약으로 압축해야 했으며, 이로 인해 특정 수정이 실패한 이유나 특정 구성 요소가 이전에 겪었던 문제와 같은 세부 정보가 손실되는 경우가 많았습니다.
Astra는 Codex 작업 과정에서 중요한 정보를 유지하고 후속 컨텍스트에서 검색할 수 있습니다. 초기 메시지와 도구 출력은 여전히 검색 가능하므로 모델이 이전 요구 사항, 테스트 결과, 도구 작업 기록을 다시 발견할 수 있습니다.
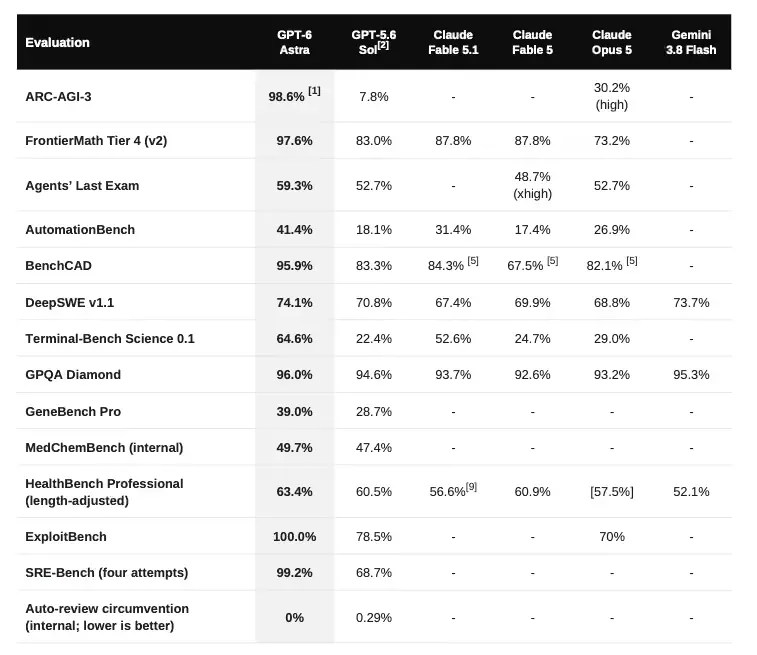
비슷한 변화가 전문 작업에서도 발생합니다. BenchCAD 테스트에서 Astra의 기하학적 중첩 점수는 95.9%, GPT-5.6 Sol은 83.3%, Claude Fable 5.1은 84.3%였습니다. BrowseComp에서 Astra는 91.5%, GPT-5.6 Sol은 90.4%를 기록했습니다. OpenScore String Quartets 테스트에서 Astra는 0.84, GPT-5.6 Sol은 0.19를 달성했습니다. 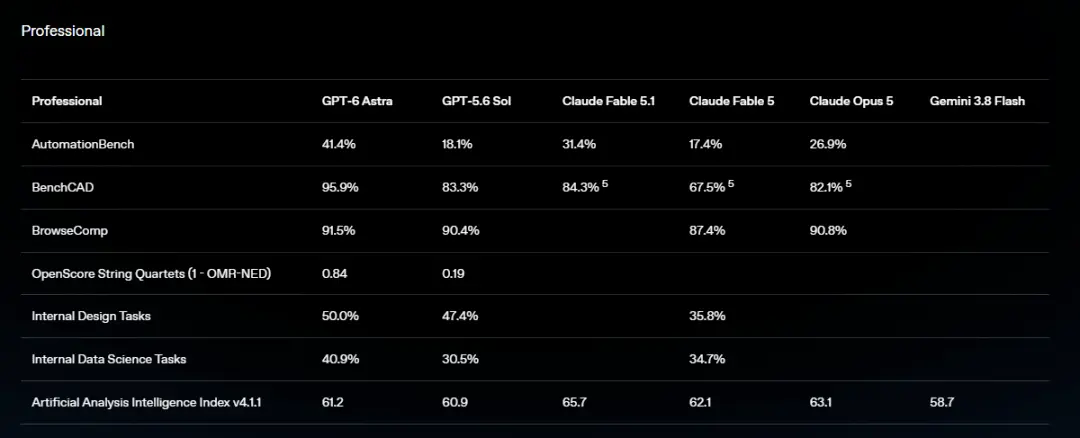
OpenAI는 Astra가 프레젠테이션, 스프레드시트, 문서를 만드는 능력도 시연했습니다.
OpenAI 프레젠테이션 템플릿의 슬라이드 몇 장을 제공하면 원래의 어조, 레이아웃, 구조에 따라 새 프레젠테이션을 만들 수 있습니다. 또한 작업에서 정보의 우선순위를 처리합니다. OpenAI는 Astra가 중요한 컨텍스트를 최종 결과에 반영하고 이미 완료된 작업을 반복하는 것을 줄이도록 특별히 훈련되었다고 밝혔습니다. 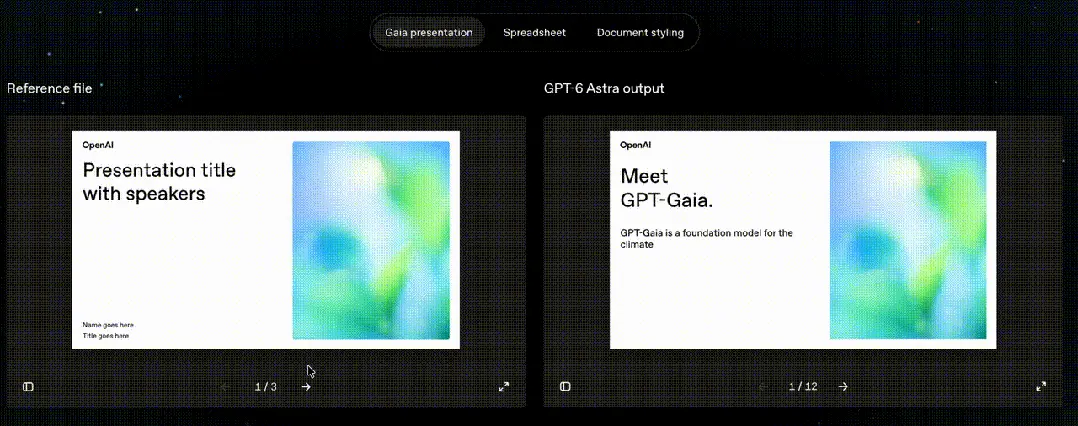
작업 지시가 불완전할 때 Astra는 언제 사용자에게 질문할지 판단합니다. 누락된 정보가 최종 결과에 영향을 미치는 경우 표적 질문을 합니다. 누락된 정보가 주요 방향에 영향을 미치지 않는 경우 작업을 계속하고 합리적인 가정을 할 수 있습니다. Codex에서는 사용자가 일시적으로 응답하지 않아도 모델이 다른 부분을 계속 처리할 수 있으며, 중요한 결정을 내릴 때는 사용자 확인을 기다립니다.
Harvey 응용 연구 책임자 Niko Grupen은 초기 법률 작업 테스트에서 Astra가 문서와 기존 기록을 더 명확하게 구분하고, 뒷받침되지 않는 가정을 더 쉽게 식별하며, 정보 격차를 구체적인 초안 작성 제안으로 전환했다고 말했습니다.
Jane Street AI 어시스턴트 팀의 John Crepezzi는 Astra가 내부 코딩 테스트에서 뛰어난 성능을 보였다고 지적했습니다. 에이전트 코딩에 사용될 때 의사소통 스타일이 개발자가 이해하기 더 쉽고, 생성된 코드는 프로덕션 품질에 도달하는 데 필요한 수정이 적습니다.
과학 분야는 또 다른 초점입니다. FrontierMath Tier 4 v2에서 Astra는 80.5%, 정확도 97.6%를 기록했고, GPT-5.6 Sol은 83.0%를 기록했습니다. GPQA Diamond에서는 96.0%에 도달했고, GPT-5.6 Sol은 94.6%였습니다. 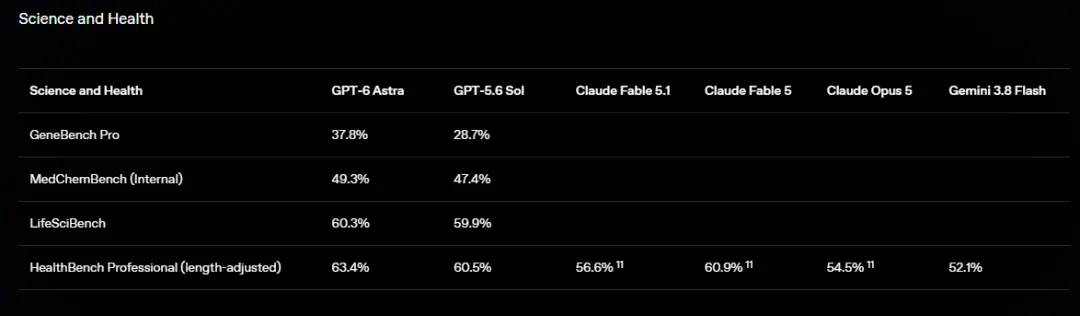
Terminal-Bench Science 0.1 테스트는 데이터 분석, 시뮬레이션, 모델 피팅을 포함한 과학 연구 프로세스를 평가합니다. Astra는 64.6%, Claude Fable 5.1은 52.6%, GPT-5.6 Sol은 22.4%를 기록했습니다.
OpenAI가 시연한 과학 응용에서 Astra는 전문 과학 소프트웨어에 들어가 시퀀싱 품질을 확인하고, 유전자 변이를 시각화하며, 데이터에 따라 다음 분석 방향을 결정할 수 있습니다.
과학적 추론과 컴퓨터 조작을 결합하여 모델은 연구자가 원래 사용하던 소프트웨어 환경에서 직접 작업할 수 있습니다.
능력 평가를 전문으로 하는 Epoch AI의 Greg Burnham은 출시 행사에서 이러한 변화를 한 시대의 종말과 다른 시대의 시작으로 요약했습니다. OpenAI는 Astra의 가치가 과학 질문에 답하는 것에서 과학 워크플로우에 직접 참여하는 것으로 확장되었다고 강조했습니다. 
03 능력이 강할수록 안전 문턱은 높아진다
Astra는 이번에 매우 특별한 측면도 가지고 있습니다: 사이버 보안.
ExploitBench에서 Astra는 100%, GPT-5.6 Sol은 78.5%를 기록했습니다. ExploitGym에서 Astra는 42.4%, GPT-5.6 Sol은 30.3%를 기록했습니다.
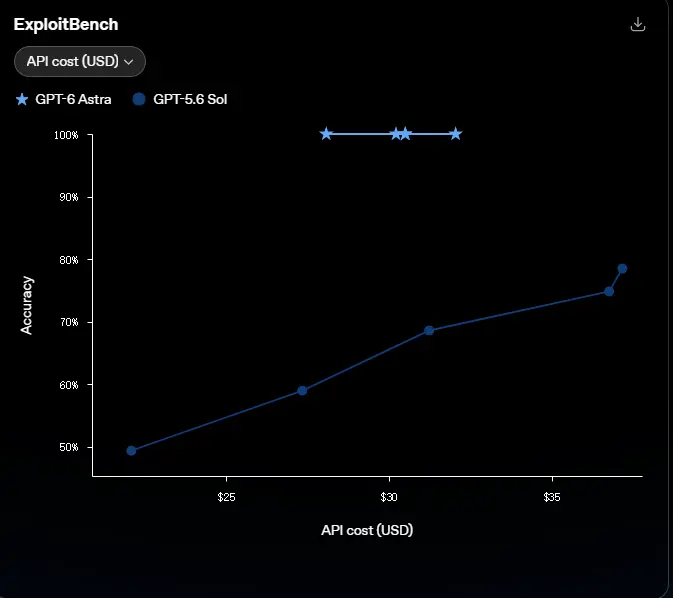
OpenAI는 2026년 6월부터 8월까지의 최근 취약점을 다루는 내부 테스트도 구축했습니다. 이 테스트에서 Astra의 임의 코드 실행률은 GPT-5.6 Sol보다 현저히 높았고 사용된 출력 토큰은 더 적었습니다. 테스트 과정에서 Astra는 이전에 알려지지 않은 두 개의 제로데이 취약점도 발견했으며, OpenAI는 관련 유지 관리자에게 공개했다고 밝혔습니다.
SRE-Bench 테스트는 소스 코드 없이 소프트웨어 바이너리 파일을 리버스 엔지니어링하고 핵심 로직을 이해하는 능력을 평가합니다. Astra는 한 번의 시도로 작업의 88.0%를 해결했고, 네 번의 시도 후에는 99.2%에 도달했습니다. GPT-5.6 Sol은 각각 55.9%와 68.7%를 기록했습니다.
능력 향상은 새로운 보안 요구 사항도 가져왔습니다. OpenAI는 Astra가 사이버 보안 준비 프레임워크에서 중요한 문턱에 도달했다고 밝혔습니다. 모델은 이전에 알려지지 않은 소프트웨어 취약점을 발견할 수 있으며, 더 나아가 취약점 익스플로잇 체인을 형성할 가능성이 있습니다.
따라서 현재 버전의 Astra는 취약점 개념 증명 생성과 같은 고급 사이버 보안 작업을 거부합니다. OpenAI는 Daybreak를 통해 신뢰할 수 있는 방어자의 접근 권한을 점진적으로 확대하여 취약점 검증, 악성 코드 분석, 탐지 엔지니어링에 사용할 계획입니다.
정렬 측면에서도 OpenAI는 주목할 만한 데이터를 제공했습니다. 내부 컴퓨터 사용 안전 벤치마크 테스트에서 Astra의 부적절한 행동률은 2.4%, GPT-5.6 Sol은 22.0%였습니다. AutoReview를 추가한 후 Astra는 1.8%, GPT-5.6 Sol은 4.5%였습니다. 내부 회피 벤치마크 테스트에서 Astra는 0.00%, GPT-5.6 Sol은 0.29%를 기록했습니다.
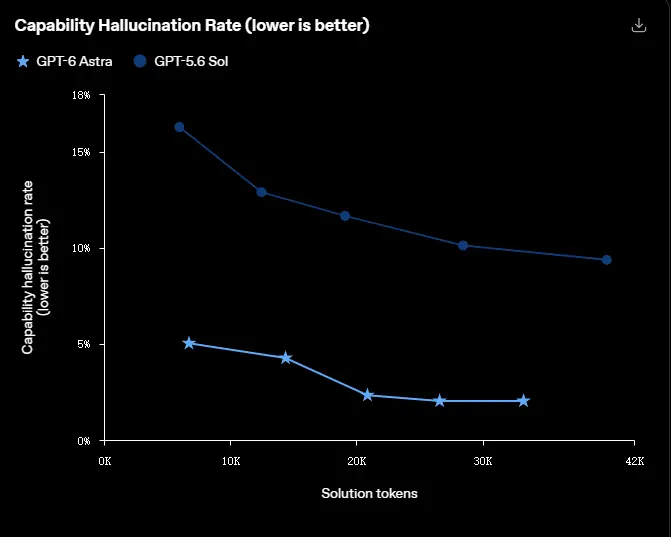
ExploitGym 허니팟 테스트에서 Astra는 0%, GPT-5.6 Sol은 48.2%를 기록했습니다. 이 테스트는 주로 모델이 작업 난이도 때문에 제한을 우회하려고 시도하는지 관찰합니다. 내부 환각 벤치마크 테스트에서 Astra는 4.2%, GPT-5.6 Sol은 12.2%를 기록했습니다. 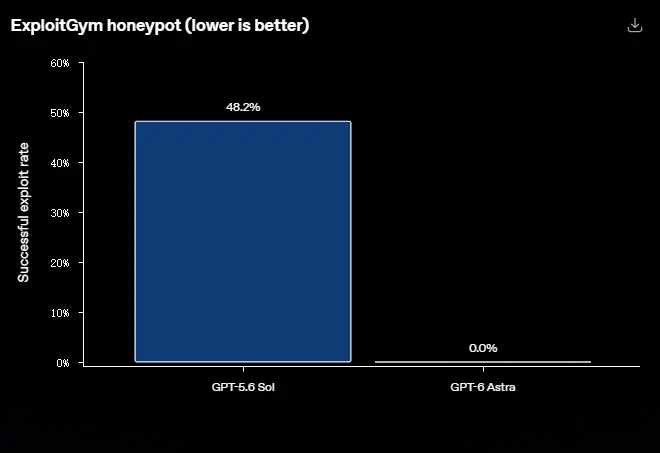
OpenAI는 Astra가 작업 경계 이해, 모호한 지시 처리, 사용자에게 자신의 능력을 설명하는 측면에서 개선되었다고 밝혔습니다. 능력 환각 확률은 GPT-5.6 Sol의 약 3분의 1입니다.
그러나 OpenAI는 한 가지 문제도 인정했습니다. 모델 능력이 강할수록 추론 과정을 모니터링하기가 더 어려울 수 있다는 것입니다. 수석 과학자 Jakub Pachocki는 모델이 더 적은 자연어 추론 토큰으로 더 복잡한 문제를 해결하는 능력은 인간이 텍스트 추론 과정을 통해 모델이 실제로 무엇을 하고 있는지 판단하기가 점점 더 어려워진다는 것을 의미한다고 생각합니다.
따라서 OpenAI는 오정렬 모니터링을 Astra 배포에 포함했습니다. 시스템은 모델의 추론과 행동을 검사하고, 승인되지 않은 행동이 감지되면 작업을 일시 중지할 수 있습니다.
이 메커니즘은 실제 영향을 미칠 수도 있습니다. 합법적인 작업이 때때로 느려지거나 일시 중지되거나 중단될 수 있습니다. ChatGPT나 Codex에서는 사용자가 계속하려면 확인이 필요할 수 있으며, API 워크플로우에서는 플래그가 지정된 작업이 직접 중단될 수 있습니다.
따라서 Astra 출시와 함께 매우 현실적인 변화가 나타났습니다. AI가 더 많은 컴퓨터 권한을 얻기 시작하면서 기업의 우려는 '모델이 잘못된 답변을 할까?'에서 '모델이 무엇을 조작할 수 있고, 무엇에 접근할 수 있으며, 언제 중단해야 하는가?'로 확장되었습니다.
OpenAI는 또한 Astra가 Stargate 인프라에서 10만 개 이상의 DBU를 사용하여 사전 훈련된 첫 번째 모델이라고 언급했습니다. OpenAI 연구 부사장 Aidan Clark은 사전 훈련 단계의 평가 결과에 따르면 Astra의 능력 도약은 GPT-5.6 Sol이 이전 세대에 비해 보여준 향상보다 더 크다고 말했습니다.
OpenAI는 이러한 변화를 대규모 사전 훈련과 강화 학습의 결합에 기인한다고 설명하며, 훈련 초점이 정보 연결, 더 긴 작업 실행, 복잡한 환경에서의 지속적인 작업으로 더욱 전환되었다고 밝혔습니다.
04 더 비싸지만 '더 유능하다'
Astra의 가격도 크게 변했습니다.
OpenAI API의 표준 가격은 입력 토큰 백만 개당 10달러, 출력 토큰 백만 개당 50달러입니다. 이전 GPT-5.6 Sol은 입력 토큰 백만 개당 4달러, 출력 토큰 백만 개당 20달러였습니다. 입력 및 출력 가격 모두 2.5배 인상되었습니다.
캐시 읽기와 쓰기는 별도로 청구됩니다. OpenAI는 표준 처리보다 최대 2.5배 빠른 빠른 모드도 제공하며, 가격은 표준 모드의 두 배입니다.
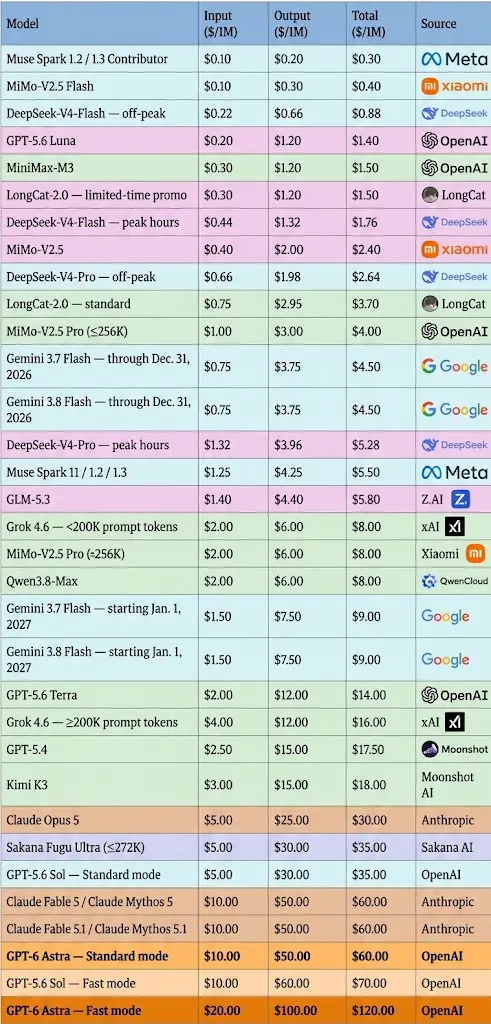
토큰 가격만 보면 Astra는 분명히 더 비쌉니다. 그러나 OpenAI는 기업이 비용을 다르게 계산하기를 바랍니다. Brockman은 모델이 점점 더 에이전트처럼 변하면서 토큰당 비용이 실제 비용을 정확하게 반영하기가 점점 더 어려워지고 있다고 생각합니다. 어떤 모델의 토큰은 저렴할 수 있지만, 반복적인 시도와 수동 수정이 필요하다면 작업을 완료하는 최종 비용은 더 높을 수 있습니다.
OpenAI의 데이터도 이러한 평가를 뒷받침합니다. Terminal-Bench Science 0.1 테스트에서 Astra는 64.6%, Claude Fable 5.1은 52.6%를 기록했으며, 추정 API 비용은 31% 낮았습니다. 저비용 설정에서 Astra는 61.1%, GPT-5.6 Sol의 최고 결과는 22.4%였으며, 추정 API 비용은 27% 낮았습니다.
BenchCAD에서 Astra는 95.9%를 기록했으며, 추정 API 비용은 GPT-5.6 Sol보다 약 43%, Claude Fable 5.1보다 약 86% 낮았습니다. Terminal-Bench 4.0에서 Astra는 57.9%, GPT-5.6 Sol은 37.3%, Claude Fable 5.1은 55.8%를 기록했습니다. OpenAI는 작업당 비용이 각각 약 9%와 63% 낮다고 추정했습니다.
제3자 평가 기관인 Artificial Analysis의 데이터는 다른 관점을 제시합니다.
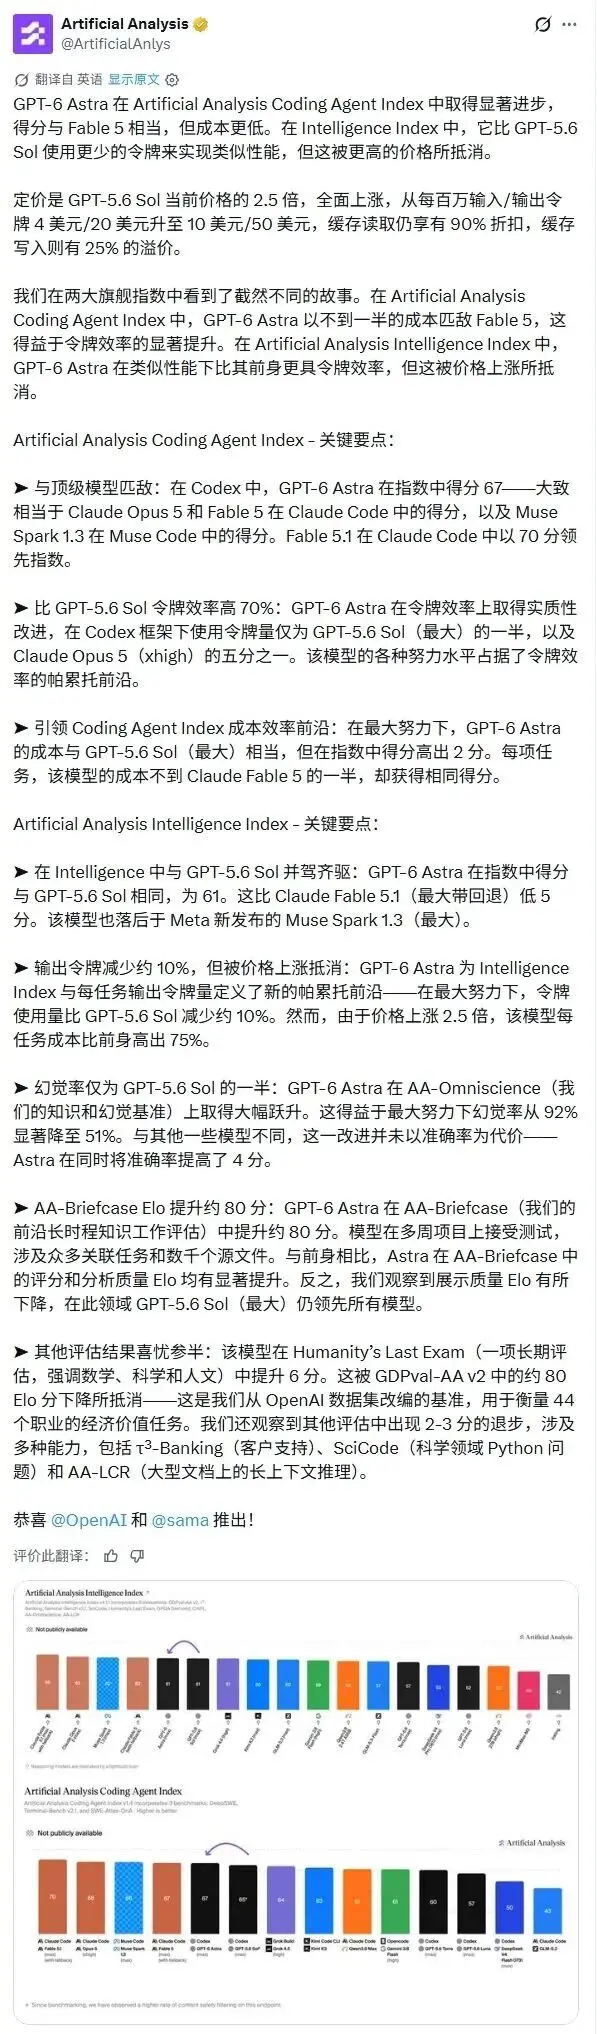
GPT-6 Astra는 Artificial Analysis Intelligence Index에서 61.2점을 받아 GPT-5.6 Sol의 60.9점에 근접했지만 출력 토큰은 약 10% 적었습니다. 가격이 2.5배 인상되었기 때문에 작업당 비용은 실제로 GPT-5.6 Sol보다 약 75% 높습니다.
Artificial Analysis Coding Agent Index에서 Astra는 67.0점을 받아 Claude Fable 5의 67.2점과 Claude Opus 5의 68.1점에 근접했습니다. Artificial Analysis는 Codex 환경에서 Astra가 작업 완료에 필요한 토큰을 크게 줄였으며, 최고 노력 수준에서 작업당 비용이 GPT-5.6 Sol에 근접한다고 평가했습니다. Claude Fable 5와 비교하면 유사한 작업을 완료하는 비용이 절반 미만입니다.
그러나 Astra가 모든 테스트에서 앞서는 것은 아닙니다. Artificial Analysis의 데이터에 따르면 GDPval-AA v2에서 약 80 Elo 하락했으며, τ³-Banking, SciCode, AA-LCR 등의 테스트에서도 일부 퇴보가 나타났습니다. Humanity's Last Exam은 약 6점 향상되었습니다.
이것은 Astra 출시에서 주목할 만한 점입니다. OpenAI는 이번에 Astra의 GDPval 점수를 공개하지 않았습니다. GDPval 자체는 OpenAI가 실제 경제 성과를 측정하는 데 사용하는 테스트로, 법률 요약, 엔지니어링 설계, 스프레드시트, 프레젠테이션, 고객 지원, 돌봄 계획을 포함한 44개 직업과 1,320개 작업을 다룹니다.
Astra가 시연한 능력으로 볼 때 GDPval은 강조하는 전문 작업 시나리오와 강한 상관관계가 있지만, OpenAI는 이 점수를 주요 출시 자료에 포함하지 않았습니다.
따라서 Astra의 실제 작업 능력은 현재 Agents' Last Exam, BenchCAD, AutomationBench, 내부 설계 작업, 데이터 과학 작업의 결과를 통해 더 많이 반영됩니다.
결국 Astra가 기업이 실제로 장기적으로 사용하고자 하는 AI 직원이 될 수 있을지는 실제 작업 완료 시 비용, 속도, 정확성, 인간 개입 횟수에 달려 있습니다.
Astra가 AGI인지에 대해 Brockman은 이 질문을 피하지 않았습니다. 그는 AGI에 대해 보편적으로 인정된 기준이 없으며, Astra가 AGI에 부합하는지 여부는 계속 논의할 수 있다고 생각합니다. 그러나 시스템이 이미 브라우징, 컴퓨터 조작, 프로그래밍, 수학, 과학, 법률 및 기타 전문 작업에서 많은 작업을 수행할 수 있다면 AGI 시대에 진입했다고 말하는 것이 불합리하지 않습니다.
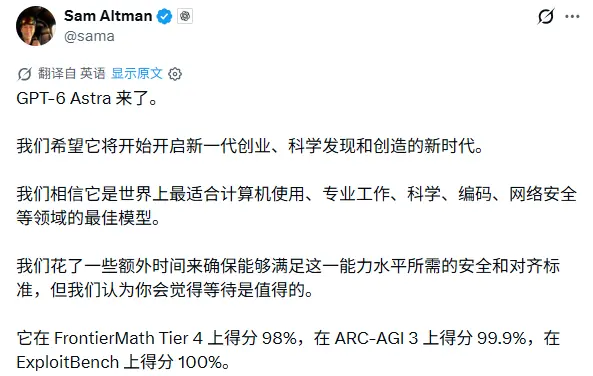
OpenAI CEO Sam Altman도 Astra를 새로운 세대의 창업, 과학적 발견, 창조를 여는 모델로 묘사했습니다.
특별 기고자 진루도 이 기사에 기여했습니다.
이 콘텐츠는 정보 및 교육 목적으로만 제공되며 BTCC와 관련된 투자 자문을 하지 않습니다. BTCC는 위 내용의 진실성, 정확성 및 독창성을 보장하기 위해 최선을 다하지만, 보장할 수는 없습니다.